Un conteneur démarre, s'arrête et redémarre
Symptom
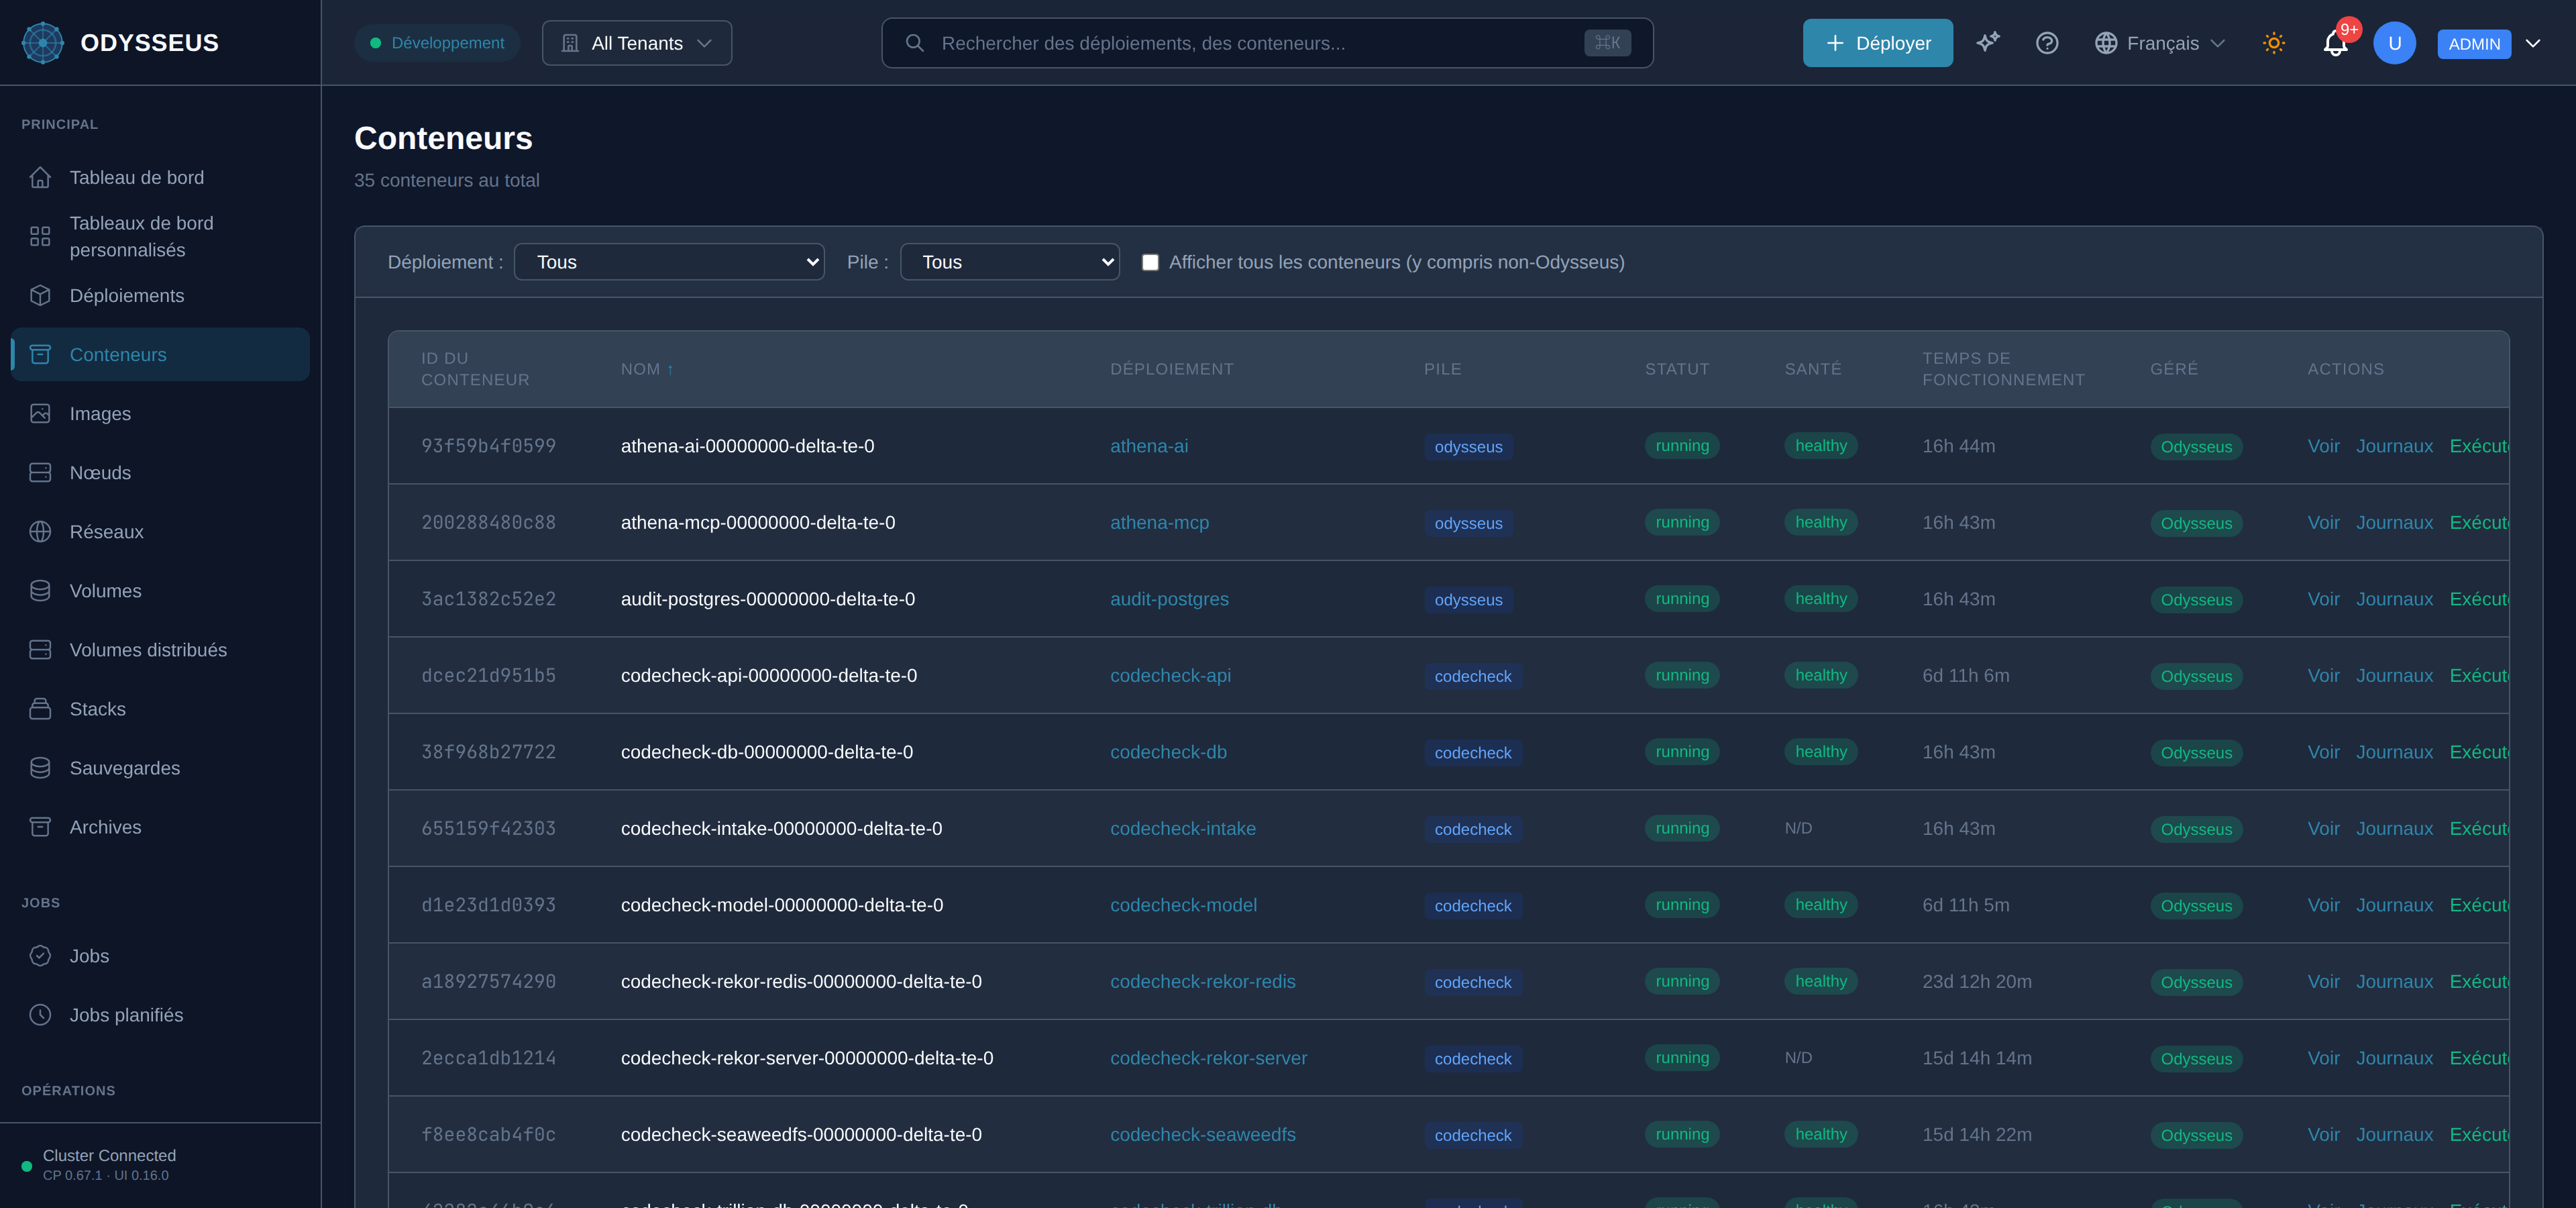
Le nombre de redémarrages du déploiement augmente. Les journaux montrent les premières lignes de l’application puis rien, à plusieurs reprises. Le statut bascule entre en cours d’exécution et non.
Diagnose
- Lisez d’abord la sortie propre du conteneur. La vue des journeaux du tableau de bord, ou
odysseus logs <deployment>. Une application qui se ferme sur une variable d’environnement manquante ou une base de données inaccessible le dit, et aucune vérification côté plateforme ne le dira mieux. - A-t-il été tué pour mémoire ? Les événements du conteneur portent la raison de la mort. Une limite mémoire atteinte est une mort, pas un crash, et le journal de l’application se termine à mi-phrase plutôt qu’avec une erreur.
- La vérification de santé le tue-elle ? Une sonde qui échoue de manière répétée est traitée comme un conteneur en échec. Exécutez la commande propre de la sonde à l’intérieur de l’image et voyez ce qu’elle fait — plusieurs images ne contiennent pas l’outil contre lequel une sonde a été écrite.
- L’image est-elle celle que vous vouliez ? Un tag qui a bougé sous vous produit un conteneur qui n’a jamais fonctionné, ce qui est identique à un conteneur cassé.
- Redémarre-t-il, ou est-il remplacé ? Un conteneur qui redémarre conserve son id. Un conteneur que la plateforme a remplacé en a un nouveau. La plateforme remplace un conteneur lorsque la forme du déploiement ne correspond plus à ce à partir de quoi ce conteneur a été construit, ou lorsque l’image derrière le tag a bougé — donc une série de nouveaux ids signifie que le déploiement est réconcilié de manière répétée, et la correction est dans ce qui réécrit le déploiement plutôt que dans l’image. Un changement du nombre de répliques seul n’est pas un tel changement et laisse les conteneurs en cours d’exécution tranquilles.
- S’est-il arrêté et n’est jamais revenu ? Alors lisez les événements,
GET /api/v1/events. Un conteneur trouvé sur un nœud sans enregistrement de déploiement derrière est supprimé plutôt que seulement signalé, et la suppression est publiée commeorphan.deleted. Le balayage s’exécute toutes les quinze minutes, prend les conteneurs arrêtés uniquement, et agit uniquement après avoir confirmé que l’enregistrement est absent lors d’une seconde lecture, qu’il pouvait voir tout le nœud, et que le conteneur nomme son propriétaire. Chacun de ces refus est publié aussi, commeorphan.deletion_refused— donc ni la suppression ni la décision de le laisser tranquille n’est silencieuse.
Resolve
- Erreur d’application : corrigez-la dans l’image, ou fournissez ce qui manque. Une boucle de redémarrage causée par la configuration est corrigée par la configuration, pas en redémarrant.
- Mort pour mémoire : augmentez la limite, ou réduisez ce que l’application détient. Changer la limite remplace le conteneur, ce qui est attendu — la colonne de mutabilité de la référence du déploiement indique quels champs font cela.
- Sonde en échec : corrigez la commande pour que l’image puisse l’exécuter, ou supprimez une sonde héritée délibérément. Voir vérifications de santé et récolte de processus.
- Mauvaise image : fixez le tag. Un tag qui n’est pas fixé est refusé à la création pour cette raison.
- Remplacé plutôt que redémarré : trouvez ce qui change le déploiement. Un remplacement est la plateforme faisant ce que le déploiement dit maintenant ; rien dans l’image ne l’arrêtera.
- Supprimé comme orphelin : le conteneur a survécu à son enregistrement de déploiement. Créez le déploiement à nouveau via l’API et la plateforme le place ; ne démarrez pas le conteneur à la main, car le prochain balayage le trouvera sans propriétaire et l’emportera à nouveau.
Prevent
Épinglez les tags d’image et rédigez une sonde qui utilise un outil que l’image contient réellement. Ces deux types d’échec sont peu coûteux à prévenir mais coûteux à diagnostiquer sous charge, car les preuves défilent.