Volumes distribués
Volumes, et pourquoi il y en a deux
Section intitulée « Volumes, et pourquoi il y en a deux »La barre latérale affiche Volumes et Volumes Distribués côte à côte, dans la section Principale, et ce ne sont pas deux vues de la même chose.
Volumes est un volume Docker simple : driver: local, un nœud, pas de réplication. Il réside sur
quel que soit le nœud sur lequel atterrit le conteneur qui l’utilise, et il disparaît si ce nœud disparaît. Utilisez-le
pour tout ce qui n’a pas besoin de survivre au départ d’un nœud.
Les Volumes Distribués sont un sous-système distinct qui réplique les données d’un volume entre les nœuds, peut déplacer les fichiers d’un volume entre les niveaux de stockage automatiquement à mesure qu’ils vieillissent, fait basculer le stockage d’un déploiement vers un nœud sain sans que vous ayez à intervenir, peut déplacer un volume vers un autre nœud pendant que le déploiement qui l’utilise continue de fonctionner, et peut signaler les volumes qui semblent mal dimensionnés ou mal classés. Utilisez-le pour tout ce qui doit survivre à la perte d’un nœud.
Quatre classes de stockage, pas un seul comportement
Section intitulée « Quatre classes de stockage, pas un seul comportement »Un volume distribué est créé avec une classe de stockage, et c’est la classe qui décide combien de ce qui précède s’applique réellement :
- Éphémère — local uniquement, pas de réplication. La même garantie qu’un volume simple, mais géré via les outils de volume distribué.
- Répliqué — réplication asynchrone vers d’autres nœuds. C’est la classe qui vous donne le choix du nombre de répliques et le basculement automatique (ci-dessous).
- Partagé — pris en charge par SeaweedFS, synchrone, et lisible et accessible en écriture depuis plus d’un nœud à la fois.
- Objet — stockage compatible S3 via MinIO.
Le nombre de répliques et le comportement de basculement automatique décrits ci-dessous s’appliquent à la classe répliquée. Un volume créé comme éphémère n’a rien à basculer, car il n’y a rien d’autre qui conserve une copie.
Ce qui se passe lorsqu’un nœud tombe en panne
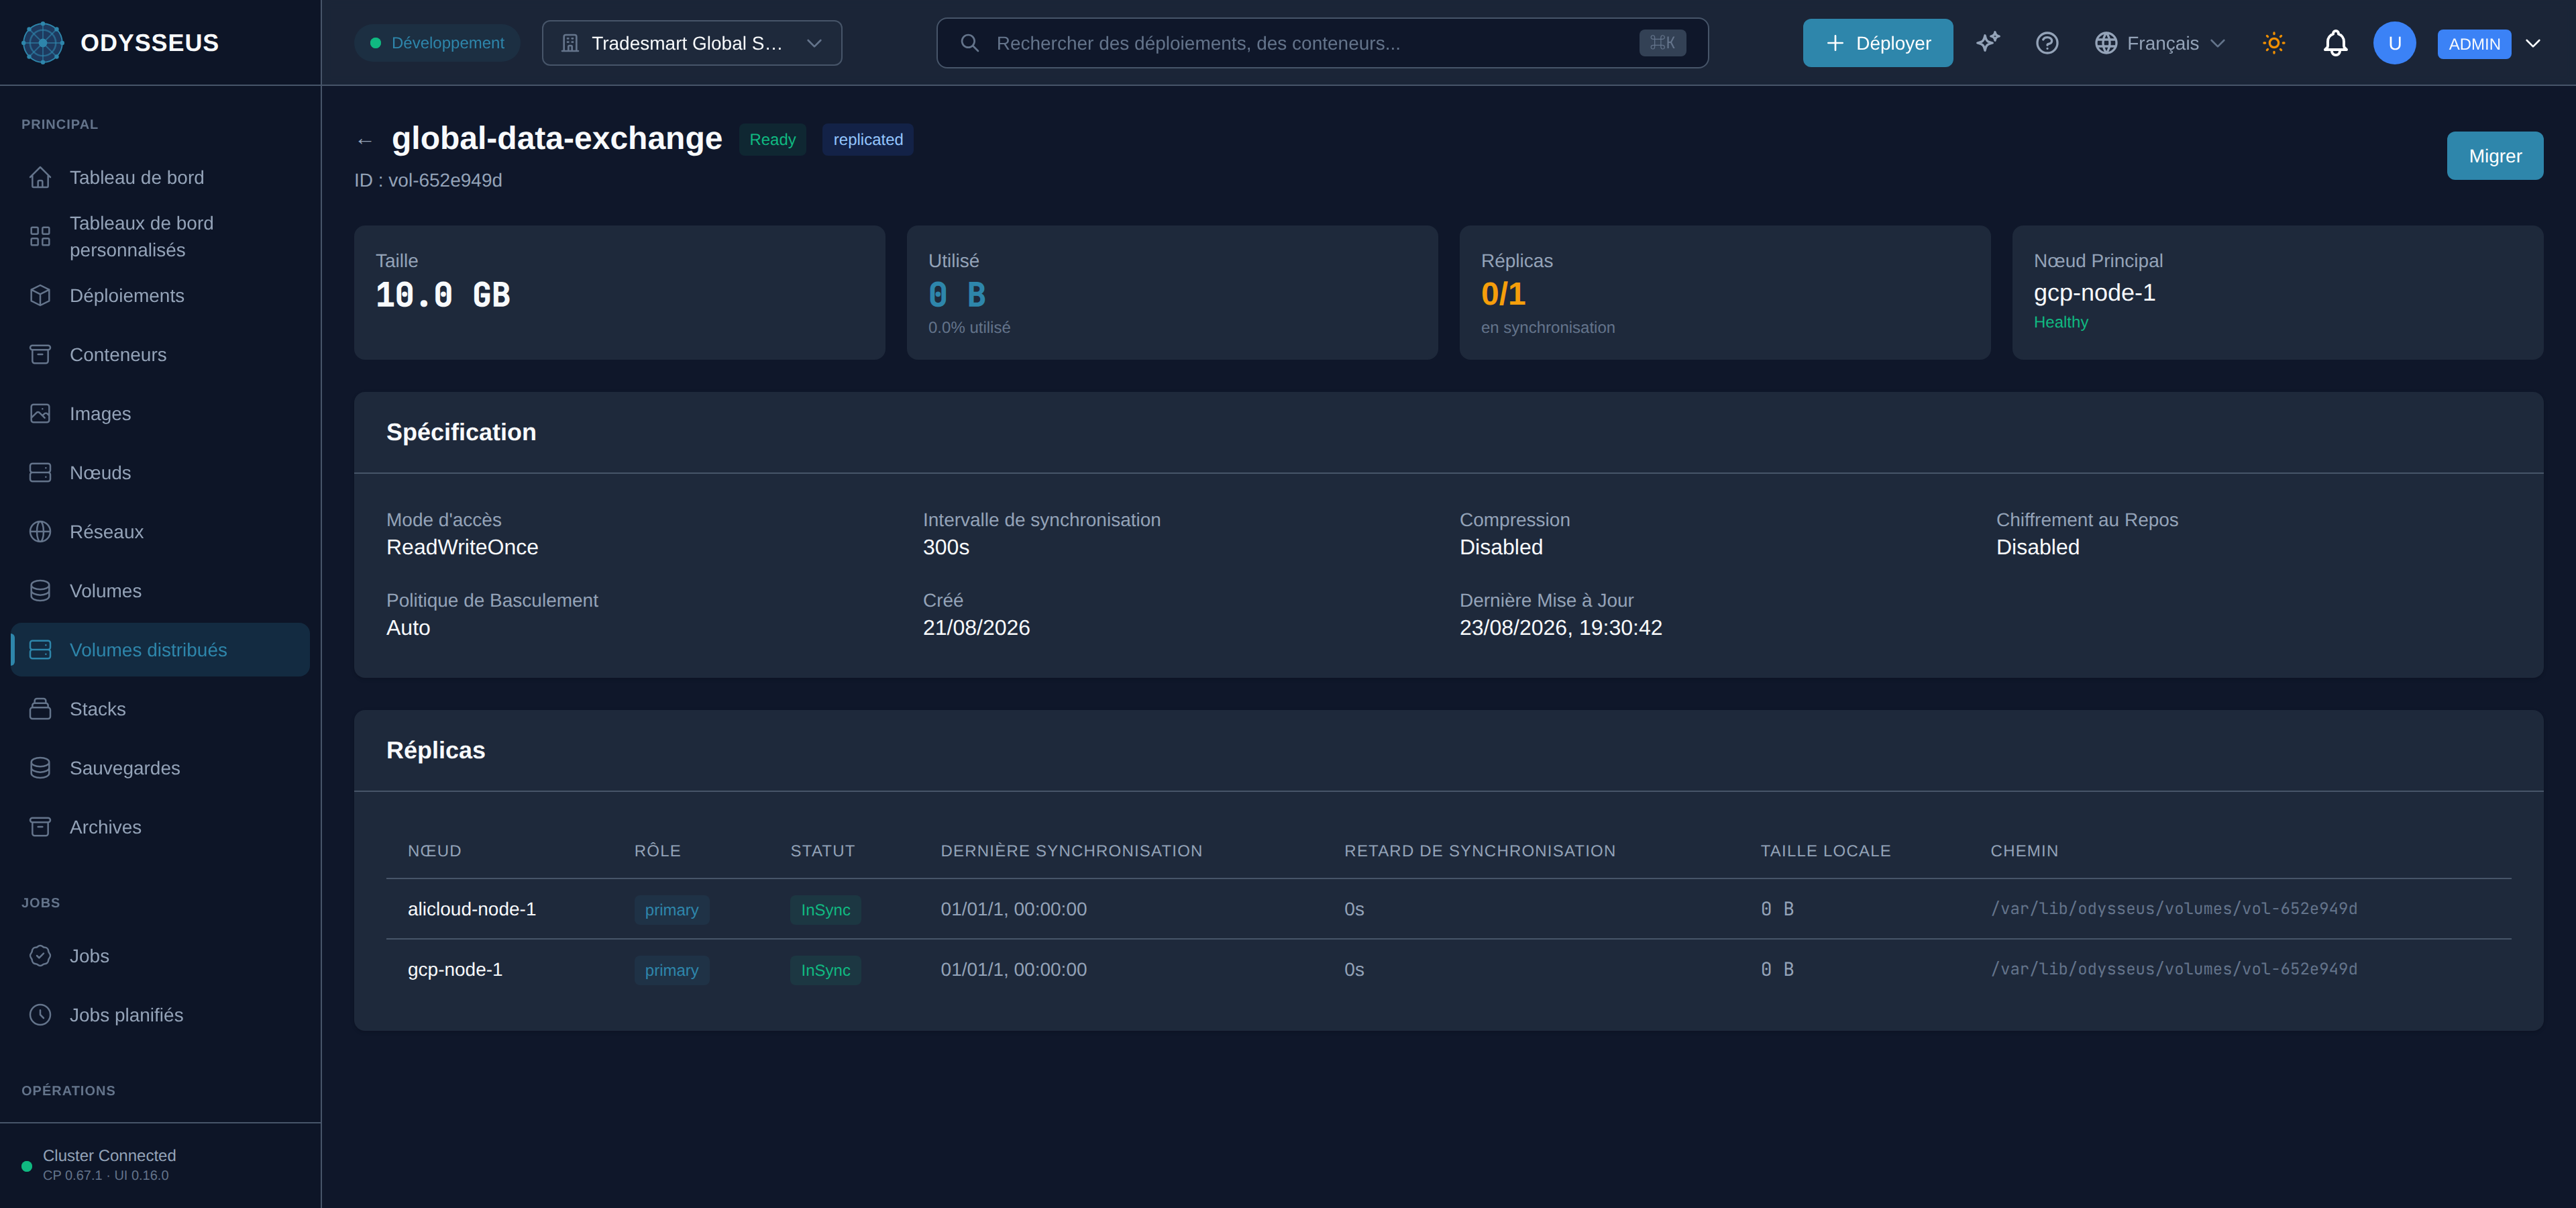
Section intitulée « Ce qui se passe lorsqu’un nœud tombe en panne »Un volume répliqué a un nœud détenant la copie primaire actuelle et un ou plusieurs nœuds détenant des répliques. Le contrôleur de basculement surveille le primaire ; s’il devient injoignable, le contrôleur choisit la réplique la plus saine et la promeut au rang de primaire — mais la promotion sans intervention humaine ne se produit que lorsque cette réplique est une copie vérifiée et fraîchement synchronisée. Une réplique simplement étiquetée comme synchronisée mais qui n’a pas prouvé qu’elle était à jour, ou qui est obsolète, revient à attendre une approbation quelle que soit la politique du volume, de sorte qu’un basculement plus rapide n’est jamais échangé contre une perte de données. Le fait que la promotion nécessite ou non une approbation est un paramètre par volume — la politique automatique promeut d’elle-même une fois qu’une réplique a franchi ce seuil de fraîcheur, la politique manuelle attend toujours une personne, même lorsqu’une réplique est à jour.
Une promotion en attente n’arrête pas les conteneurs du déploiement. Ils continuent à fonctionner avec le stockage qu’ils ont déjà ; ce que la plateforme fait à la place est d’enregistrer la requête et de marquer le volume comme défaillant, ce qui empêche tout nouveau montage jusqu’à ce que la promotion soit résolue. La requête en attente est visible sur la page propre au volume dans le tableau de bord, où un opérateur l’approuve — vous n’avez pas à la chercher dans les journaux. Lorsque la promotion se produit automatiquement, vous voyez le résultat sous forme d’événement nommant l’ancien et le nouveau nœud primaire, et non comme un temps d’arrêt.
Déplacer un volume vers un autre nœud, sans arrêter le déploiement
Section intitulée « Déplacer un volume vers un autre nœud, sans arrêter le déploiement »La copie primaire d’un volume répliqué peut être déplacée vers un nœud différent pendant que le déploiement qui l’utilise continue de fonctionner. C’est une migration, et c’est un acte délibéré : un opérateur ouvre le volume, choisit Migrer, sélectionne un nœud cible et lance l’opération.
Ce qui se passe alors, c’est que le nœud cible est ajouté en tant que réplique et commence à recevoir les données du volume, et le contrôleur de migration surveille cette copie plutôt qu’une horloge. Ce n’est que lorsque la cible se déclare synchronisée et à quelques secondes du primaire qu’elle effectue le basculement : les écritures sont suspendues pendant l’instant du changement, la cible devient le primaire et le nœud qui était le primaire reste en tant que réplique. Jusqu’à ce moment, rien n’a changé pour le déploiement, c’est pourquoi la migration peut être abandonnée à tout moment avant cela — Annuler la migration supprime la cible et laisse le primaire original exactement où il était.
Une migration est refusée avant de commencer si le nœud cible n’envoie pas de battements de cœur, ou si il n’a pas l’espace libre égal à la taille complète du volume plus un dixième de celle-ci. Pendant qu’une migration est en cours, la page propre au volume indique son avancement et une estimation de sa fin.
Ce n’est pas l’entrée Migration KV dans la barre latérale. C’est un outil sans rapport pour les administrateurs de la plateforme destiné à déplacer les enregistrements de déploiement vers une disposition de clés plus récente, et il n’a rien à voir avec les volumes.
Niveaux de stockage
Section intitulée « Niveaux de stockage »Un volume distribué peut porter une politique de niveaux de stockage optionnelle — elle est désactivée sauf si vous l’activez. Lorsqu’elle est activée, un fichier qui n’a pas été lu depuis un certain temps est déplacé du stockage chaud (local, sur le nœud) vers le stockage tiède (SeaweedFS), puis du tiède vers le stockage froid (MinIO), en fonction du nombre de jours depuis le dernier accès et de sa taille. Cela s’exécute comme une analyse périodique en arrière-plan, et ne change jamais par quel nœud un conteneur atteint le volume — seulement sur quel type de stockage un fichier donné réside réellement en coulisses.
Le composant qui transporte les octets est le déplaceur de données. Il enregistre une somme de contrôle du fichier qu’il est sur le point d’envoyer, l’envoie, et supprime la copie qu’il a déplacée uniquement une fois que le transfert a été accepté — ainsi une interruption de déplacement coûte une nouvelle tentative plutôt que la perte du fichier. Il fonctionne dans les deux sens : un fichier qui est à nouveau demandé est récupéré du stockage tiède vers le nœud où il est lu.
Recommandations
Section intitulée « Recommandations »Odysseus examine les volumes distribués d’un locataire et signale les points qui méritent d’être modifiés. Ce n’est pas un service d’arrière-plan qui les surveille au fil du temps et consigne les constats : la liste complète est élaborée à partir de l’état actuel des volumes au moment où la demande est faite. Rien concernant une suggestion n’est stocké, sauf ce que vous en avez fait — acquise, appliquée ou rejetée.
Il lit trois choses qu’un volume rapporte véritablement : sa taille déclarée et le nombre de réplicas, que vous avez définis ; le nombre d’octets qu’il contient réellement, que chaque nœud inscrit dans son propre enregistrement de réplica ; et le nombre d’instantanés qu’il possède. Tout ce qu’une suggestion indique peut être rattaché à l’un de ces éléments.
Il en existe quatre catégories.
- Capacité. Un volume utilisant 85 % ou plus de la taille qu’il a déclarée est signalé, et 95 % ou plus est signalé comme urgent. La taille suggérée lui laisse de la place pour environ doubler.
- Nombre de réplicas. Un volume répliqué en dessous du minimum défini par sa classe est signalé pour être
augmenté. Un volume que vous avez étiqueté
criticality: criticalest maintenu à un minimum de trois copies au lieu d’une. Au-delà de trois copies, les exemplaires supplémentaires sont signalés comme un coût sans tolérance aux pannes que la plateforme puisse planifier. - Classe de stockage. Un volume répliqué de plus de 100 Go est signalé comme candidat au stockage objet, avec la différence mensuelle que le modèle de coûts indique. Séparément, les données que vous avez étiquetées critiques résidant sur la classe éphémère — une copie, un nœud, aucun réplica — sont signalées comme un problème de fiabilité.
- Coût. Un volume de plus de 10 Go contenant moins du tiers de ce qu’il a déclaré est signalé comme surdimensionné, avec une taille plus petite qui conserve 50 % de marge par rapport à ce qui est réellement stocké. Plus de dix instantanés sur un seul volume sont signalés pour révision. Lorsque les économies identifiées représentent plus d’un dixième des dépenses de stockage modélisées du locataire, un résumé est placé en tête de la liste.
Certaines de ces suggestions peuvent être appliquées pour vous et d’autres non, et chacune indique laquelle. Une suggestion de capacité ou de surdimensionnement modifie la taille déclarée du volume ; une suggestion de nombre de réplicas modifie le nombre et sélectionne les nœuds, en conservant les réplicas qui détiennent déjà une copie synchronisée afin qu’aucun ne soit contraint à une resynchronisation complète inutile. Une suggestion de classe de stockage ne peut pas être appliquée — déplacer un volume entre des classes est une migration de niveau, et Odysseus n’en expose pas aujourd’hui — et le nettoyage des instantanés ne sera pas effectué pour vous, car la suppression d’un instantané est irréversible et vous seul savez lesquels vous avez encore besoin. Dans les deux cas, la suggestion contient la raison en termes clairs, et le tableau de bord ne propose pas un bouton qu’il sait être refusé.
Deux choses qu’un lecteur pourrait attendre sont délibérément absentes. Il n’y a pas de suggestion « ce volume n’a pas été modifié depuis des mois » et pas de suggestion « celui-ci est lu constamment, déplacez-le quelque part de plus rapide », car les statistiques d’accès par volume ne sont pas collectées aujourd’hui — le suivi au niveau du fichier qui les alimenterait appartient au moteur de niveaux, qui n’est pas en cours d’exécution. Une règle qui ne peut pas se déclencher est pire qu’une règle manquante, car son absence de votre liste est interprétée comme une bonne nouvelle.
Acquérir une suggestion la conserve à l’écran, marquée. La rejeter la retire de la liste jusqu’à ce que la situation qu’elle décrit change — l’identité d’une suggestion est dérivée du constat, donc un volume qui se remplit à nouveau en produit une nouvelle plutôt que de réactiver celle que vous avez rejetée.
Instantanés
Section intitulée « Instantanés »Odysseus ne prend pas d’instantané à un point dans le temps des données d’un volume distribué, et l’API
le dit au lieu de prétendre le contraire. Les deux points de terminaison de création d’instantané —
POST /api/v1/tenants/{tenant}/volumes/{id}/snapshots et
POST /api/v1/dvm/volumes/{id}/snapshots — répondent 501 Not Implemented, et le refus
nomme ce qui couvre les besoins proches. Ils répondaient auparavant 202 Accepted avec un identifiant
d’instantané pour un travail qui ne démarrerait jamais et ne pourrait jamais être récupéré. Les codes
lisibles par machine et la formulation exacte se trouvent dans la référence des rejets.
La liste, la récupération et la suppression d’instantanés fonctionnent toujours. Ils lisent un magasin qui est vide par conception plutôt que par erreur, donc une récupération explique que l’enregistrement n’allait jamais exister plutôt que de ressembler à un identifiant égaré.
Not this
Les Volumes Distribués ne remplacent pas la réplication propre d’une base de données (un déploiement Postgres avec ses propres réplicas en streaming ne tire aucun bénéfice à résider également sur un volume distribué — les deux mécanismes seraient redondants). Ils ne fournissent pas non plus d’instantanés à un point dans le temps par eux-mêmes : la réplication maintient une seconde copie de ce que le volume contient maintenant, ce qui n’est pas une copie de ce qu’il contenait hier, et un réplica réplique fidèlement une suppression. Les deux systèmes d’instantanés qu’Odysseus possède couvrent la description d’un déploiement plutôt que ses données — l’ écran Backups pour un annulation rapide après un changement risqué, et l’ écran Archives pour des copies planifiées et versionnées auxquelles vous pouvez remonter plus loin. Aucun d’eux ne sauvegarde les octets sur un volume ; cela reste à votre charge à organiser à l’intérieur du déploiement.
Où le voir
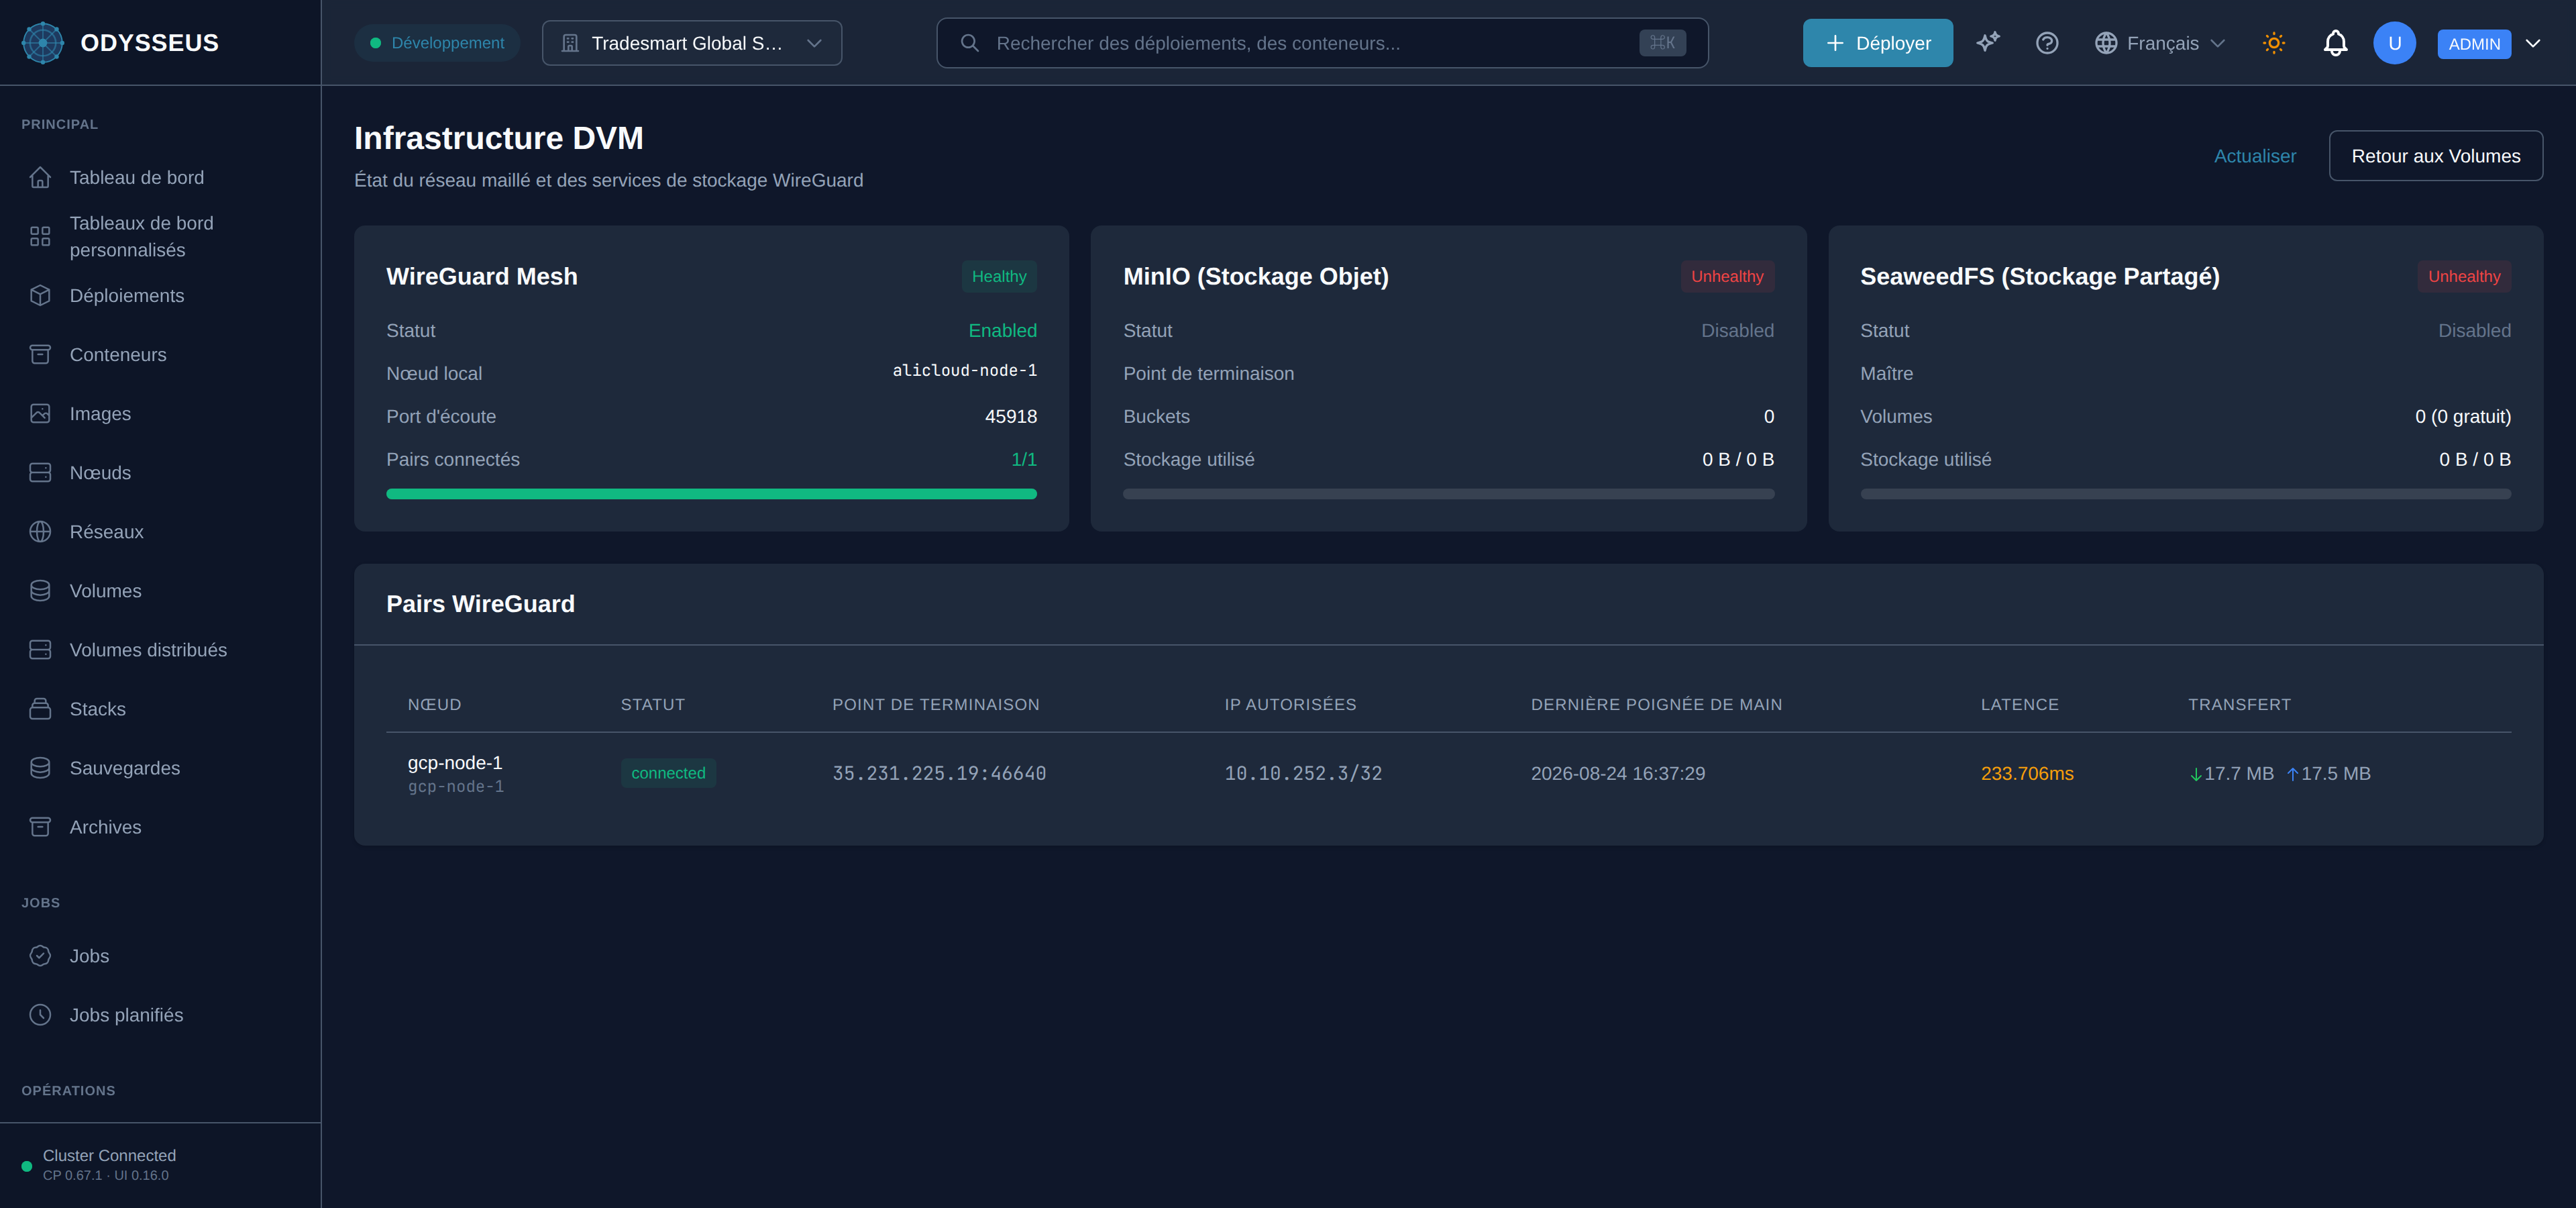
Section intitulée « Où le voir »L’écran Volumes Distribués liste chaque volume distribué, sa classe de stockage et la santé de ses réplicas, et c’est là que vous en créez un. Ouvrir un volume affiche sa spécification complète, l’état des réplicas et les étiquettes, et contient les contrôles Migrer, Basculer et les contrôles d’approbation décrits ci-dessus. La même référence d’écran couvre les deux vues qui en sont accessibles : État du maillage, qui affiche le maillage WireGuard sur lequel la réplication voyage entre les nœuds et la santé du stockage partagé et objet derrière les classes qui les utilisent, et Recommandations, qui est l’endroit où les quatre catégories de suggestion ci-dessus apparaissent, chacune avec l’action qu’elle peut effectuer en votre nom ou la raison pour laquelle elle ne le peut pas. Pour en créer un et l’attacher à un déploiement, consultez le guide des tâches des volumes distribués.