Mises à jour progressives
Le problème
Section intitulée « Le problème »Remplacer tous les conteneurs à la fois est honnête et peu coûteux : le déploiement est brièvement interrompu, et tout le monde le sait. Les remplacer un par un est ce que la plupart des gens veulent — mais ce n’est sûr que lorsque trois conditions sont vraies, et chacune d’entre elles est facile à supposer.
La nouvelle copie doit être manifestement prête, sinon le trafic se dirige vers quelque chose qui ne sert pas. Deux versions doivent pouvoir fonctionner côte à côte, sinon la mise à jour progressive « douce » corrompt l’état partagé. Et la chose qui est transférée doit être quelque chose que deux copies peuvent partager à tout moment : un volume en lecture-écriture ou un port publié sur le nœud ne l’est pas.
Comment la plateforme résout le problème
Section intitulée « Comment la plateforme résout le problème »La stratégie par défaut remplace tout à la fois, car c’est la seule stratégie sans préconditions.
Toute approche plus douce doit énoncer ses préconditions et être vérifiée par rapport à celles-ci. Une mise à jour progressive est refusée à moins que le déploiement ne porte une vérification d’état de santé qui s’exécute réellement, à moins qu’il ne détienne pas un volume en lecture-écriture ou un port de nœud publié, et à moins que vous n’ayez déclaré dans la description que deux versions peuvent brièvement coexister. Cette déclaration n’est jamais déduite : la plateforme ne peut pas savoir si votre application le tolère, et deviner incorrectement est un problème de données plutôt qu’un problème de disponibilité.
La précondition sur la santé est la raison pour laquelle une sonde inerte comptait tant. La vérification est une vérification de présence — donc avant que les sondes qui ne font rien soient refusées catégoriquement, un déploiement pouvait satisfaire l’exigence de disponibilité tout en n’ayant aucune sonde. Voir vérifications d’état de santé et collecte des processus.
Une mise à jour progressive est limitée dans le temps et possède une action en cas d’échec prédéfinie. Le temps qu’une copie peut prendre pour devenir saine, le temps qu’elle doit rester saine avant l’étape suivante, le temps que l’ensemble de la mise à jour progressive peut prendre, et ce qui se passe si elle ne se termine pas sont tous des champs que vous définissez — avec des valeurs par défaut dans la référence du déploiement.
Une mise à jour progressive pondérée est un changement de routage. Envoyer une fraction du trafic vers une nouvelle version nécessite que le déploiement soit routé, car les poids sont appliqués au niveau du bord de routage.
Not this
Cette page ne répertorie pas les stratégies, les noms de champs, les valeurs par défaut ou les préconditions exactes. Elles se trouvent dans la référence générée et dans le refus que vous recevez si vous en enfreignez une.
Elle ne couvre pas non plus l’annulation d’une promotion de la plateforme elle-même, qui relève d’un runbook opérationnel plutôt que d’une propriété d’un déploiement.
Où le voir
Section intitulée « Où le voir »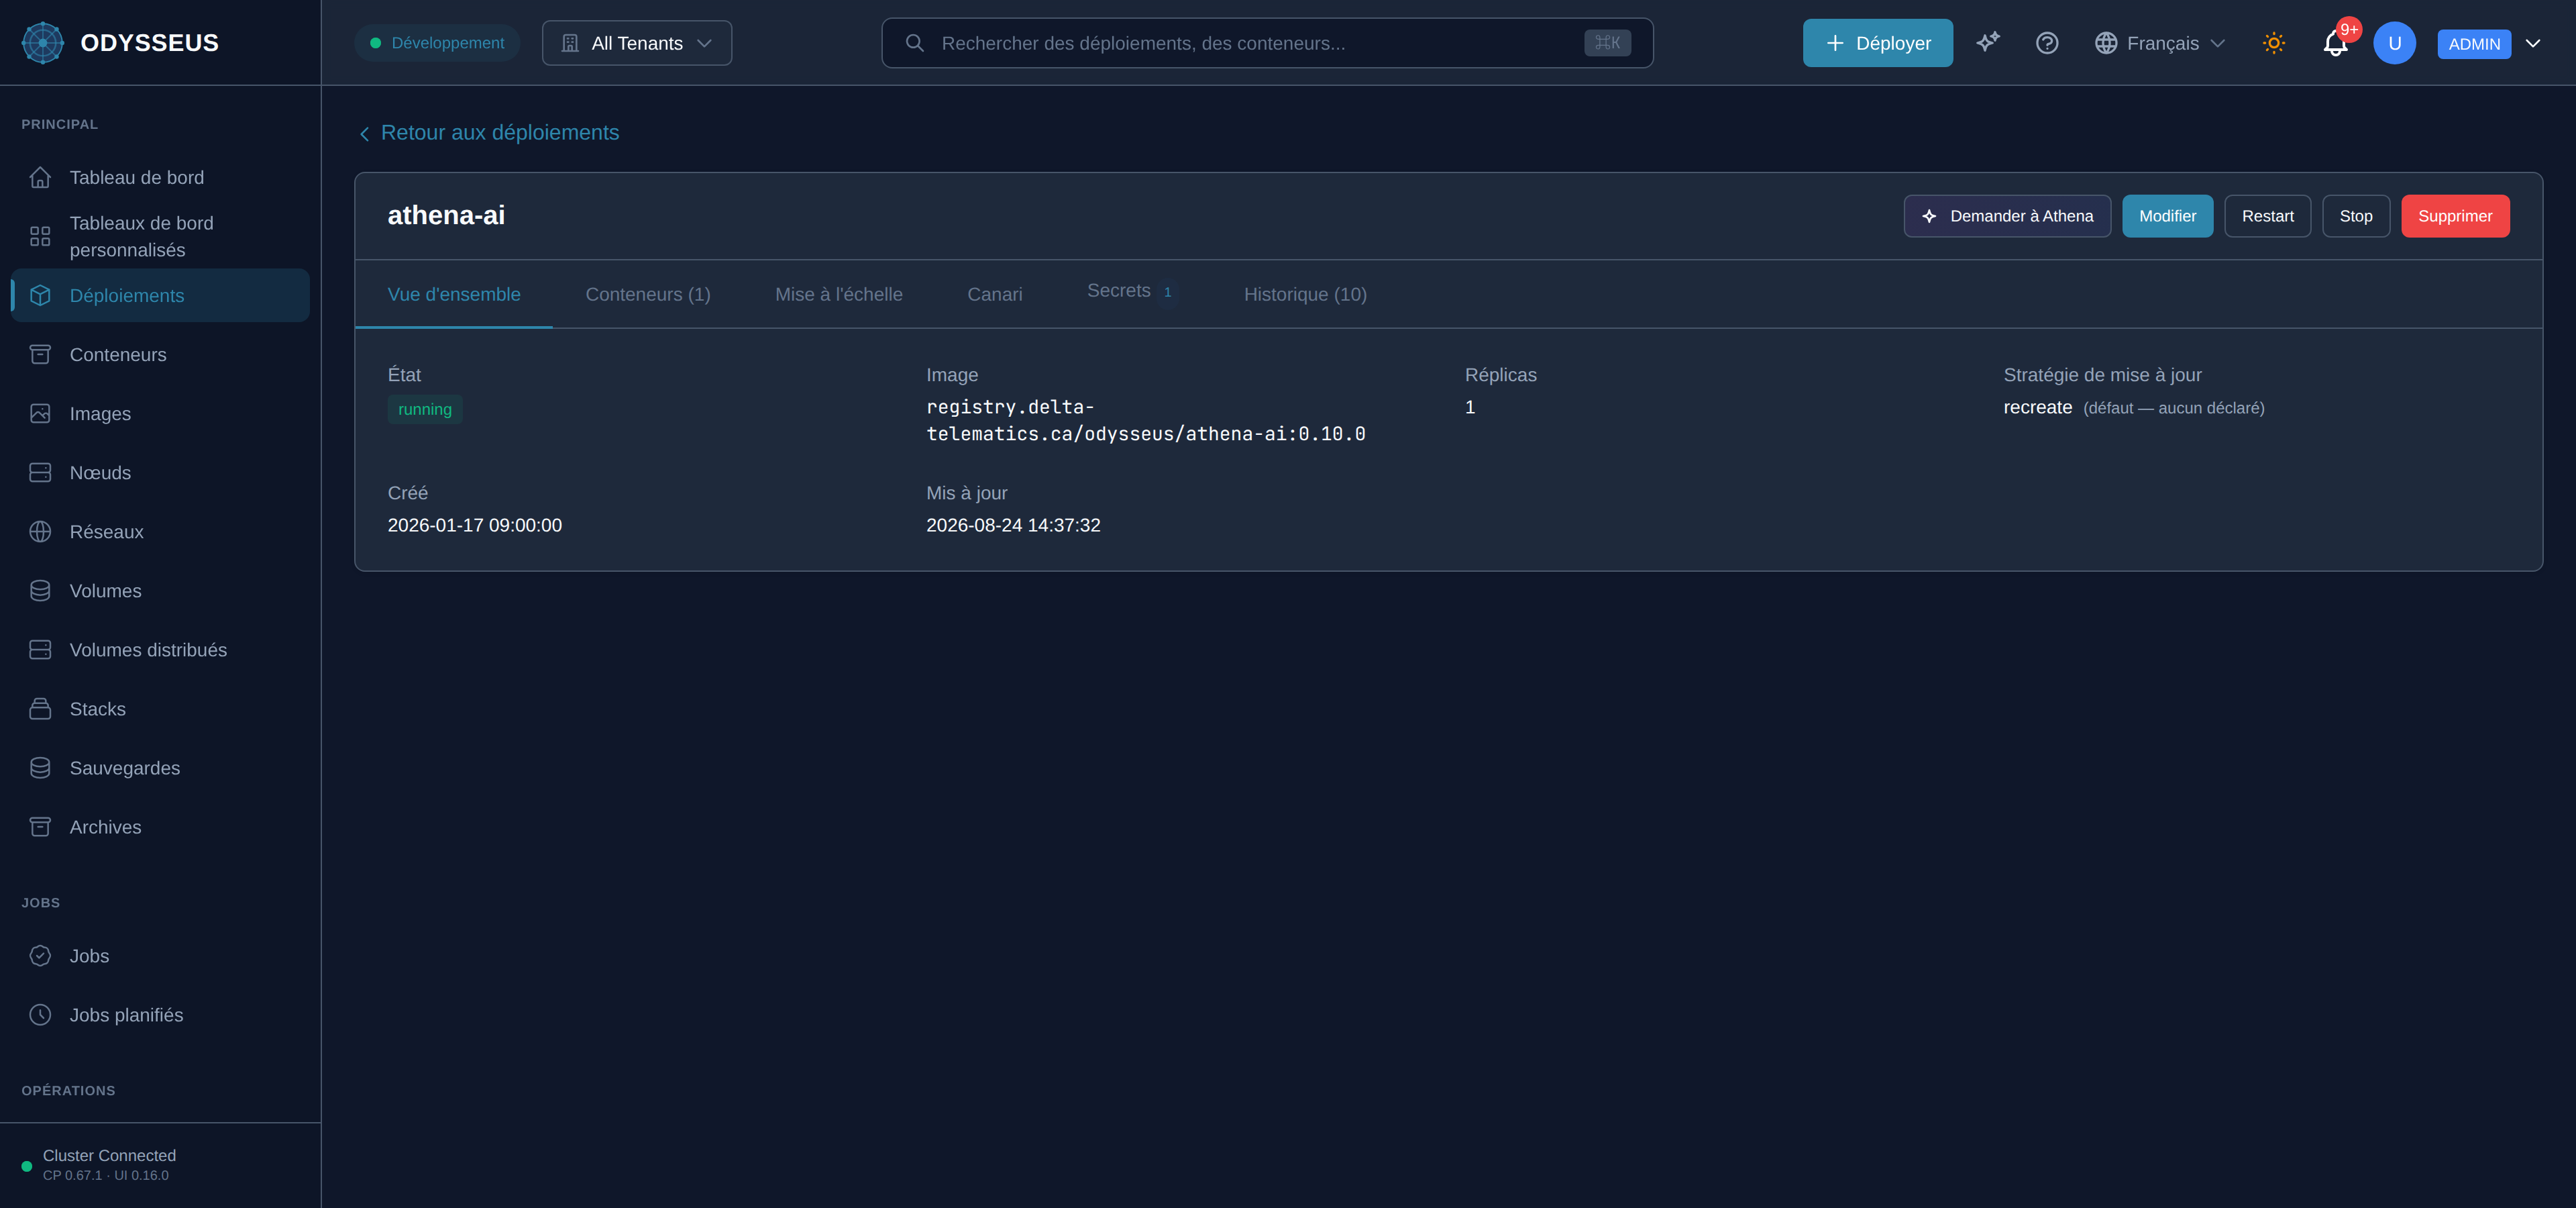
- Le bloc de mise à jour, champ par champ : manifeste de déploiement.
- Pourquoi une mise à jour progressive a été refusée, par code : rejets et altérations.