Orchestration d'entreprise.
Pas de Kubernetes requis.
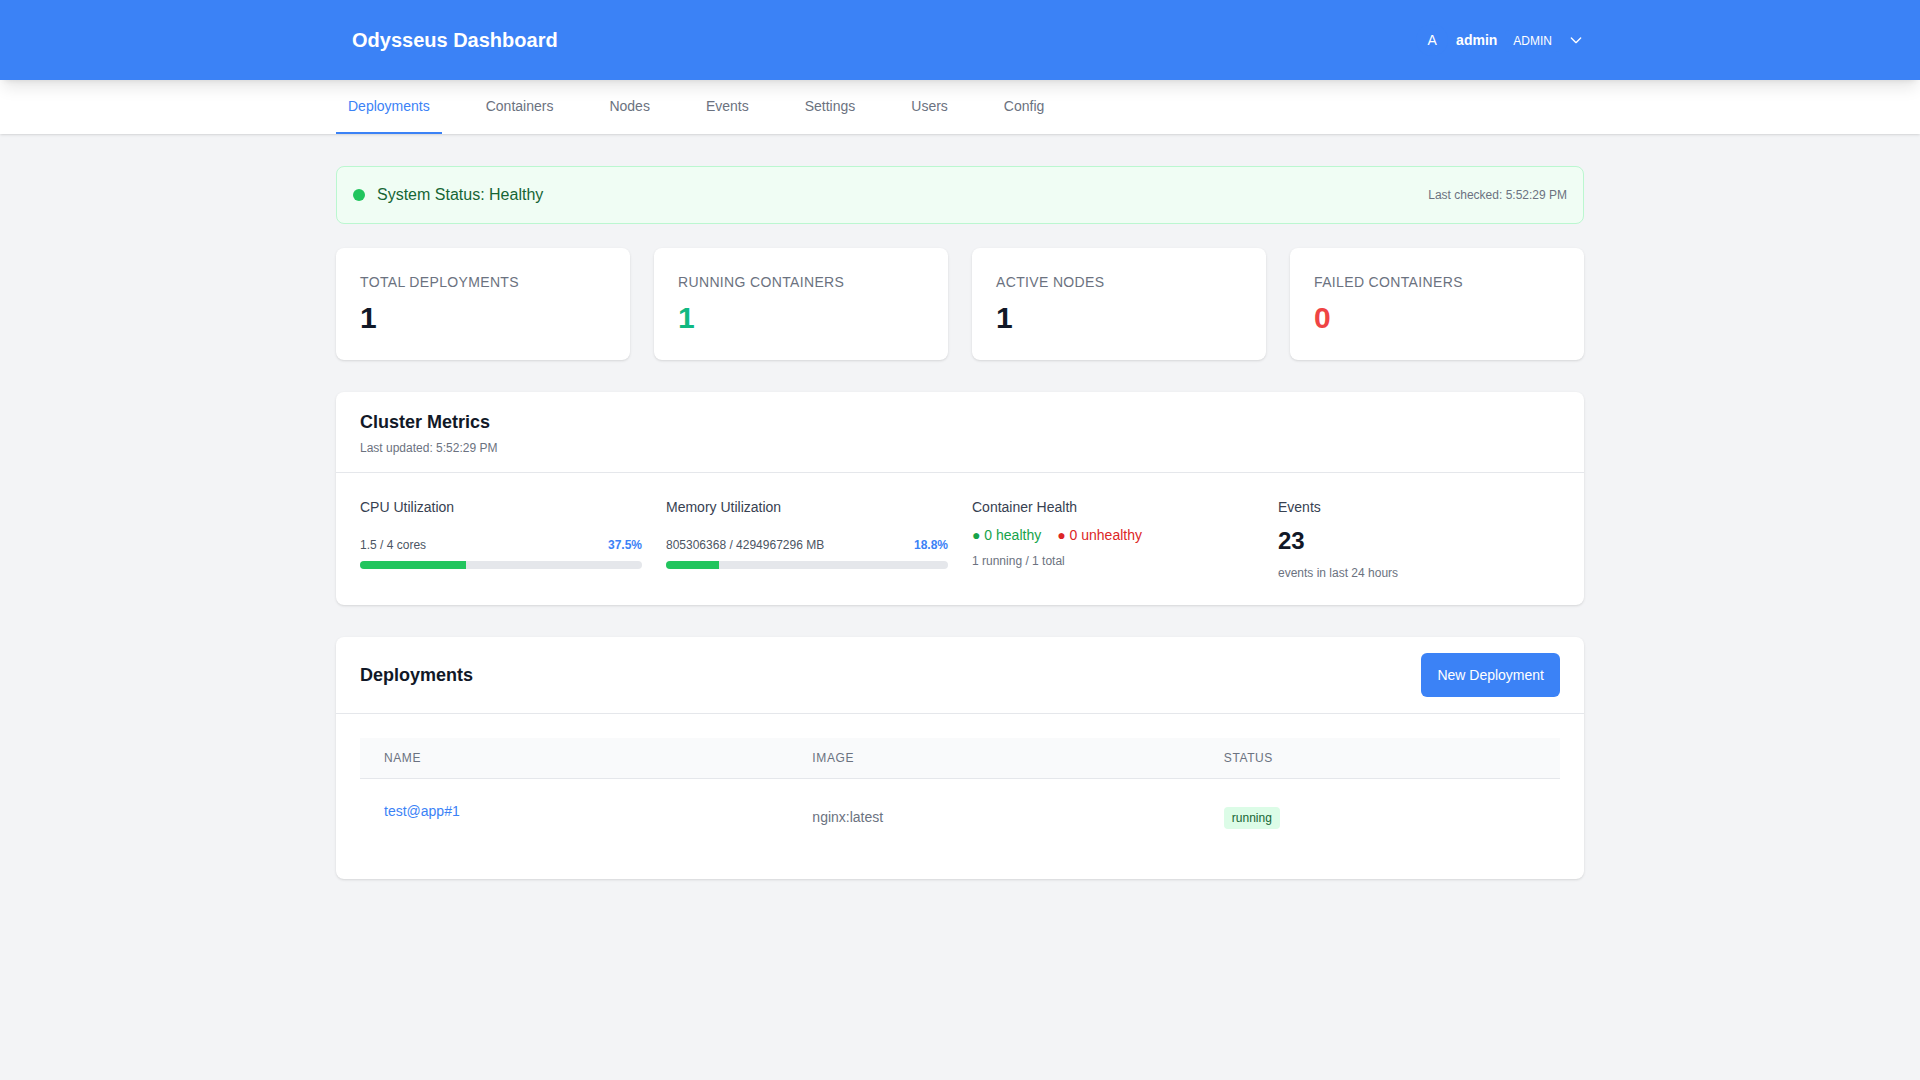
Odysseus est une plateforme d'orchestration de conteneurs entièrement gérée. Inscrivez-vous, connectez vos nœuds avec une seule ligne de commande et bénéficiez de l'autoscaling, des déploiements canary, des opérations propulsées par l'IA et de l'analyse des CVE — sans la complexité de Kubernetes.
Plan de contrôle entièrement géré · Configuration des nœuds en une ligne · Aucune équipe de plateforme dédiée
Odysseus pilote des nœuds de locataires en direct sur des clouds publics indépendants à partir d'un seul plan de contrôle — un cluster Kubernetes a un plan de contrôle par cluster, point final.
Voir la preuve multi-cloudChemins Vault par locataire, réseaux Docker par locataire et sécurité au niveau des lignes Postgres en mode échec fermé — pas une étiquette de namespace qu'une politique mal configurée peut traverser.
Lire l'audit qui l'a testéUn journal d'événements chaîné par hachage, inviolable, avec un vérificateur hors ligne autonome que vous remettez à un auditeur — pas une capture d'écran de tableau de bord qu'il doit faire confiance.
Comment la piste d'audit se prouveCoincé entre trop simple
et trop complexe ?
Gérer 50 ou 100 conteneurs ne devrait pas nécessiter une équipe de plateforme dédiée. Mais cela ne devrait pas non plus être tenu par des scripts shell.
Docker Compose atteint ses limites
Pas d'auto-scaling, pas de haute disponibilité, pas de déploiements roulants. Un mauvais push peut mettre hors service l'ensemble de votre service — et la récupération manuelle éloigne l'équipe de la livraison.
Kubernetes est surdimensionné
Un minimum documenté de 2 Go par machine, des mois de montée en compétence, 1 à 2 ingénieurs dédiés pour le maintenir. À cette taille, vous payez une taxe d'entreprise pour des fonctionnalités que vous n'utiliserez jamais pleinement.
Chaque déploiement est un risque
Pas de versions canari signifie que les bugs atteignent 100 % de vos utilisateurs instantanément. Pas de piste d'audit signifie que vous ne pouvez pas répondre à « qu'est-ce qui a changé et quand ? » pour les revues de conformité ou les post-mortems.
- 30 à 60 minutes d'étapes de déploiement manuel
- Un mauvais déploiement affecte 100 % des utilisateurs
- Mise à l'échelle manuelle lors des pics de trafic
- Pas de piste d'audit — « qui a changé ça ? » reste sans réponse
- Les secrets se trouvent dans les variables d'environnement ou les scripts bash
- La récupération après une panne prend 15 à 30 minutes
- Déploiements automatisés en 2 à 3 minutes, à chaque fois
- Les mises à jour canari exposent les bogues à 10 % avant la mise à jour progressive complète
- Mise à l'échelle automatique pilotée par Prometheus, sans intervention manuelle
- Piste d'audit complète avec acteur, horodatage et résultat
- Lire depuis Vault à la création — jamais stocké dans Consul, un manifeste ou la piste d'audit
- Retour arrière automatisé instantané en cas d'échec de la vérification d'état
Inscrivez-vous, connectez, déployez
Odysseus est entièrement géré. Inscrivez-vous, exécutez une commande pour connecter vos nœuds et commencez à déployer — le plan de contrôle est à notre charge.
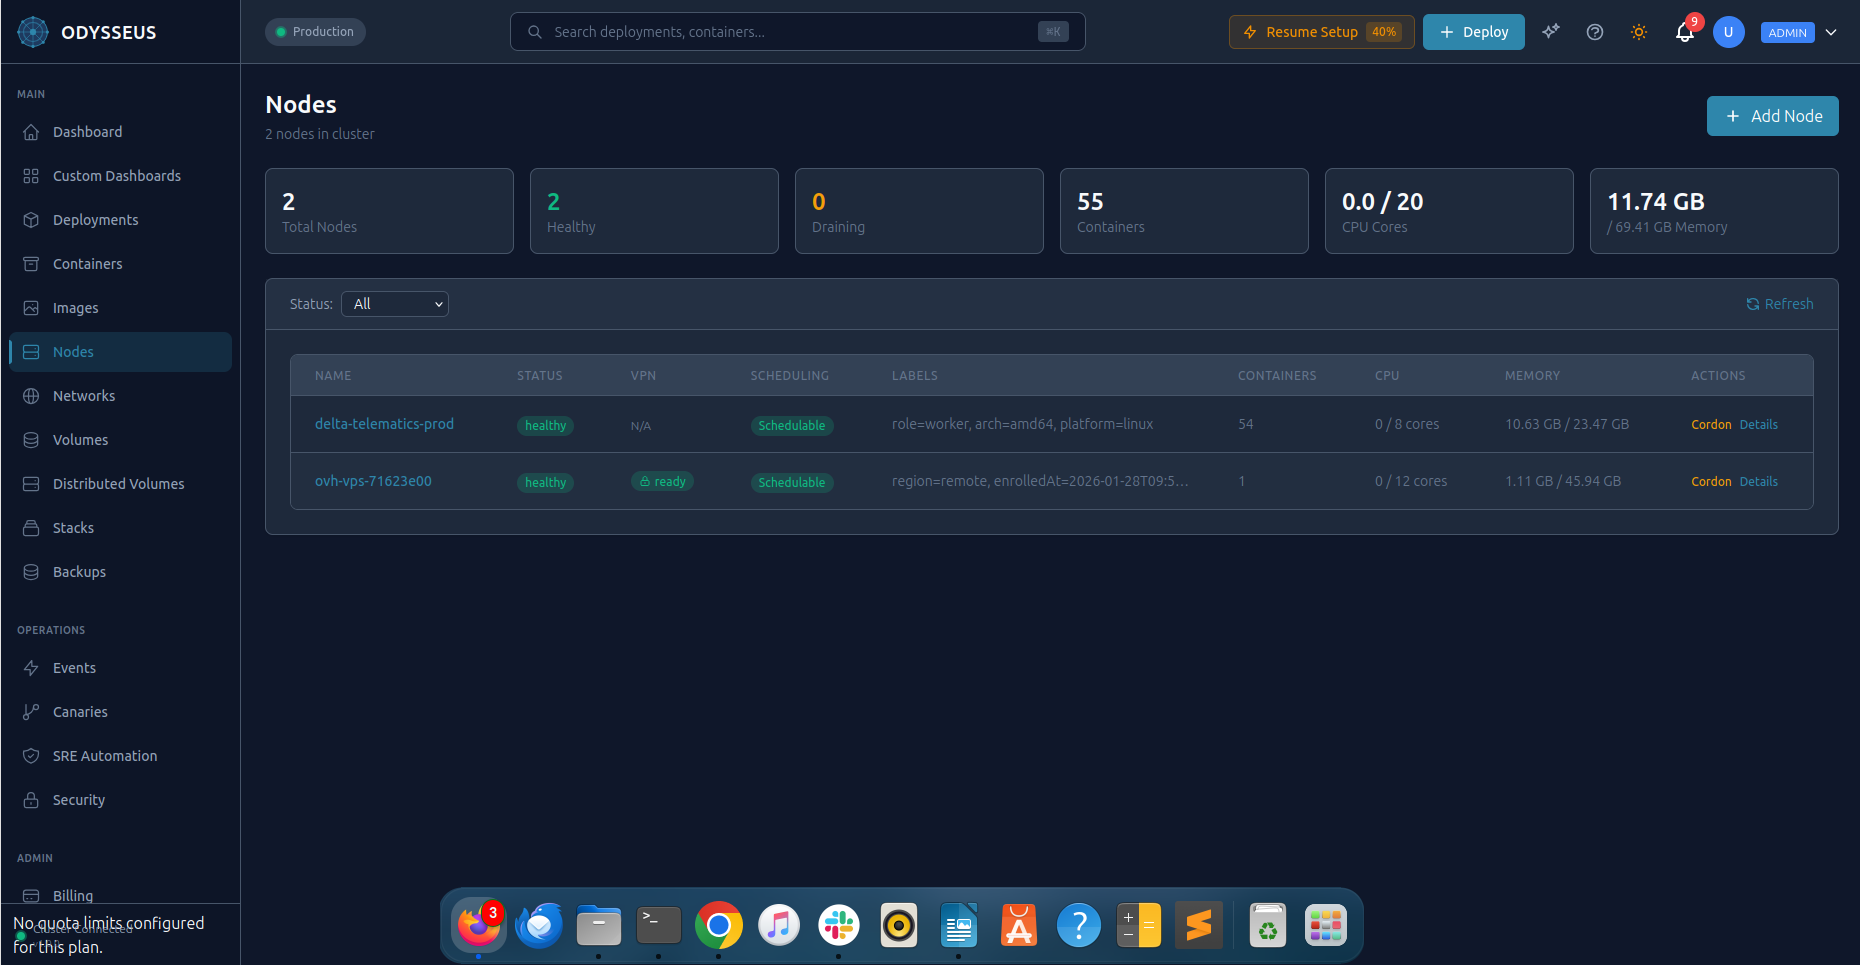
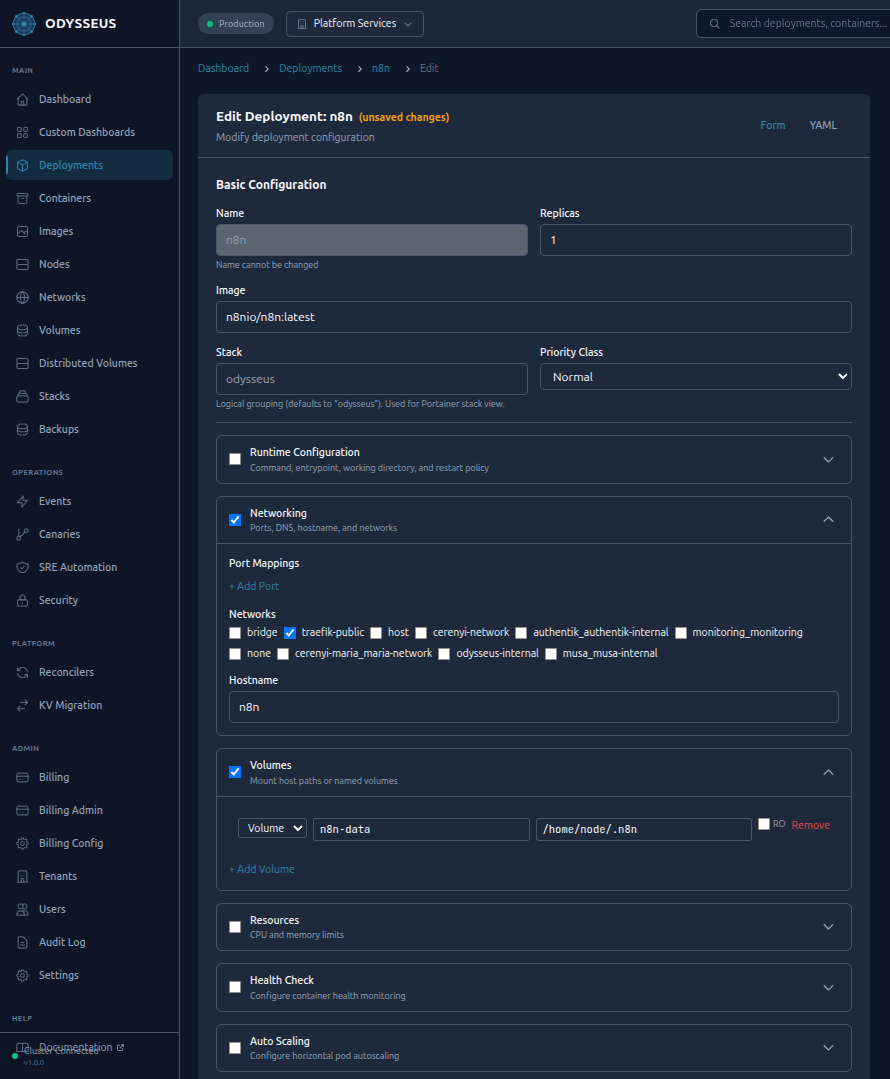
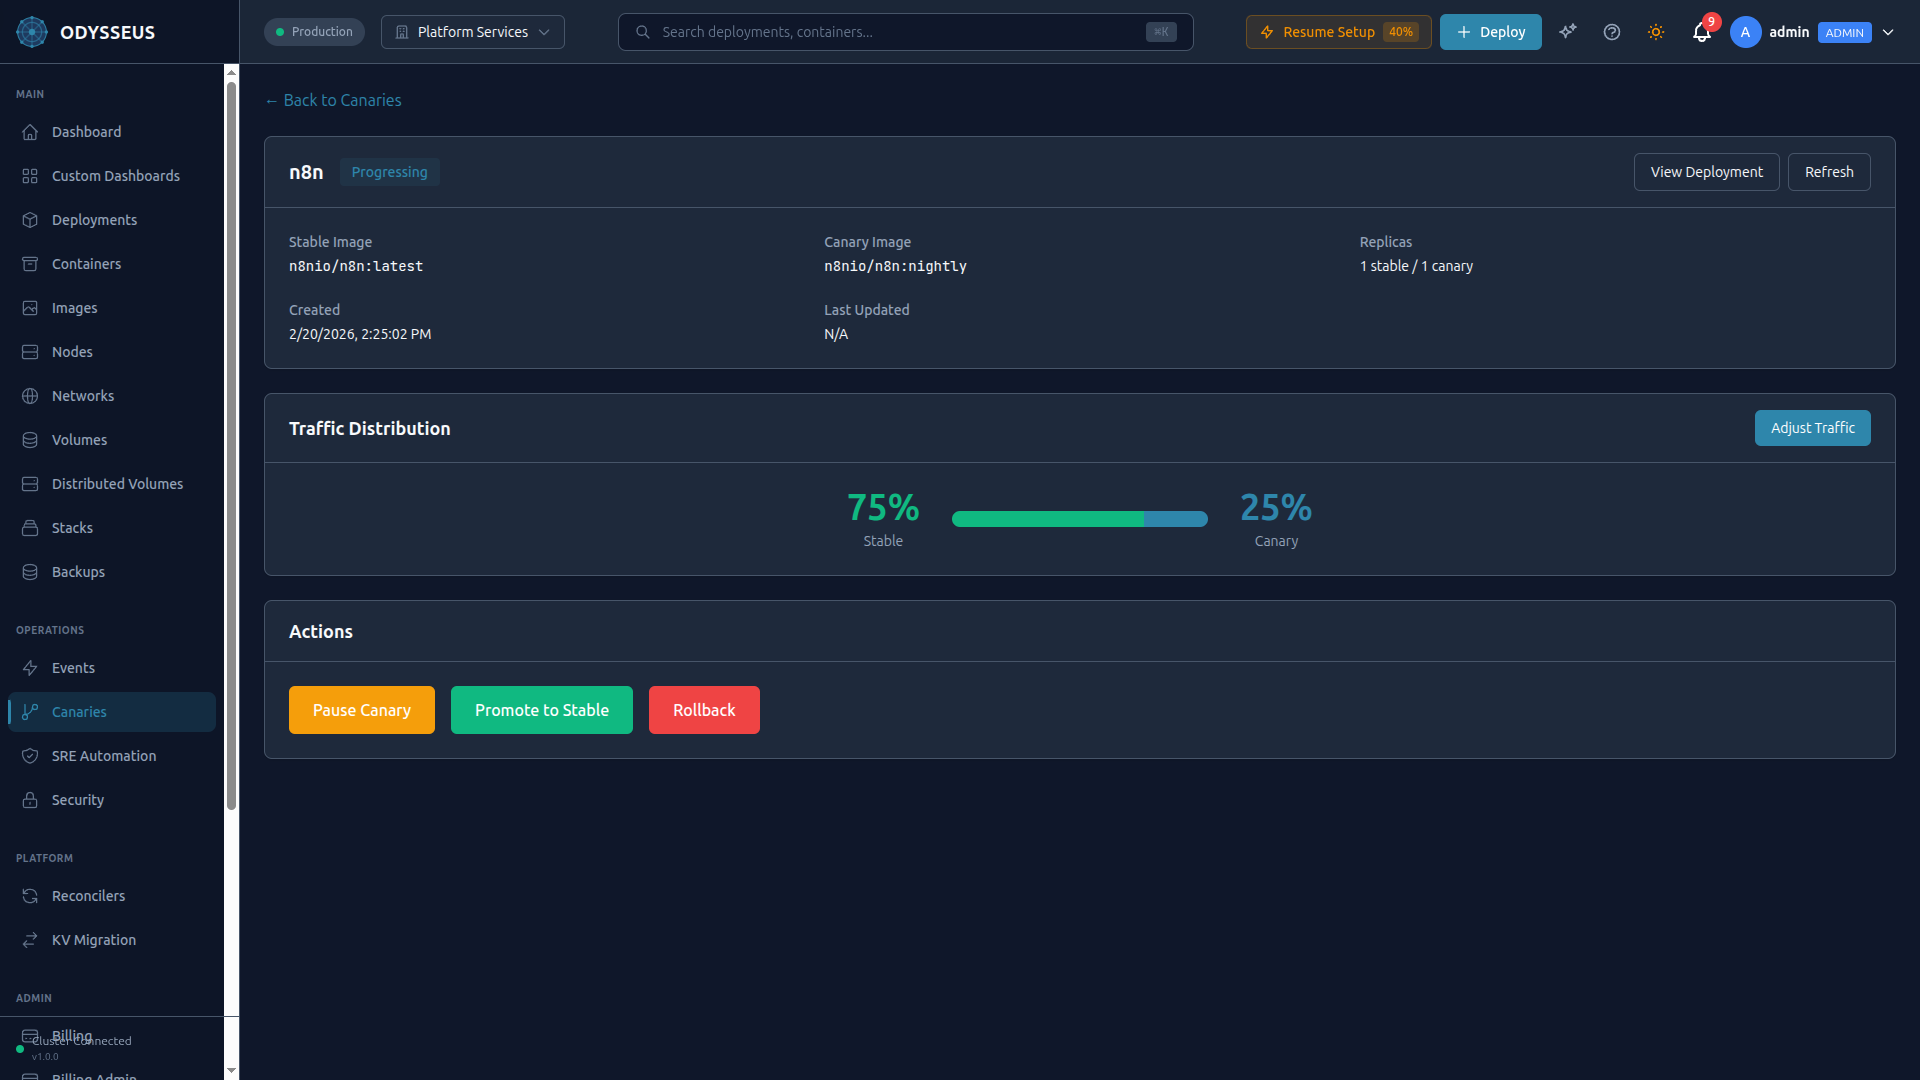
Tout ce dont vous avez besoin.
Rien de plus.
Conçu pour les équipes qui ont dépassé Docker Compose mais ne veulent pas constituer une équipe de plateforme uniquement pour exécuter leurs conteneurs.
Syntaxe Docker Compose que vous connaissez déjà
Étendez vos fichiers docker-compose.yml existants avec un bloc x-odysseus. Pas de nouveau DSL à apprendre — votre équipe livre dès le premier jour.
Attachement de conteneur multi-réseau
Attachez des conteneurs à plusieurs réseaux Docker simultanément — une limitation clé de Nomad et de nombreux autres orchestrateurs qu'Odysseus résout nativement.
RBAC à quatre niveaux
Rôles Admin, Operator, Developer et Read-only prêts à l'emploi. Contrôlez précisément qui peut déployer, mettre à l'échelle ou simplement observer — avec authentification JWT + mTLS.
Agent léger, zéro surcharge
L'agent Odysseus est un unique binaire Go qui s'exécute sur vos nœuds — environ 28 Mo de mémoire résidente, mesuré sur des nœuds de production et de développement en direct. S'installe en quelques secondes, se met à jour automatiquement avec un retour arrière conditionné par un contrôle de santé.
Réponse automatisée aux incidents
Odysseus détecte les plantages de conteneurs, les arrêts OOM, les boucles de redémarrage et les échecs de vérification d'état en temps réel — puis exécute des remédiations automatiquement. Infrastructure auto-réparatrice sans fatigue d'astreinte.
Analyse CVE intégrée
Analyse de vulnérabilités à double backend avec Trivy et Grype. Définissez des politiques pour bloquer automatiquement les déploiements avec des CVE critiques. Obtenez des recommandations de correctifs avec une priorisation basée sur la sévérité.
Rencontrez Athena — votre assistant IA pour les opérations
Déployez, dépannez et gérez l'infrastructure en langage naturel. Athena se connecte à 84 outils d'orchestration[6] avec un accès RBAC-scopé et des garde-fous de sécurité.
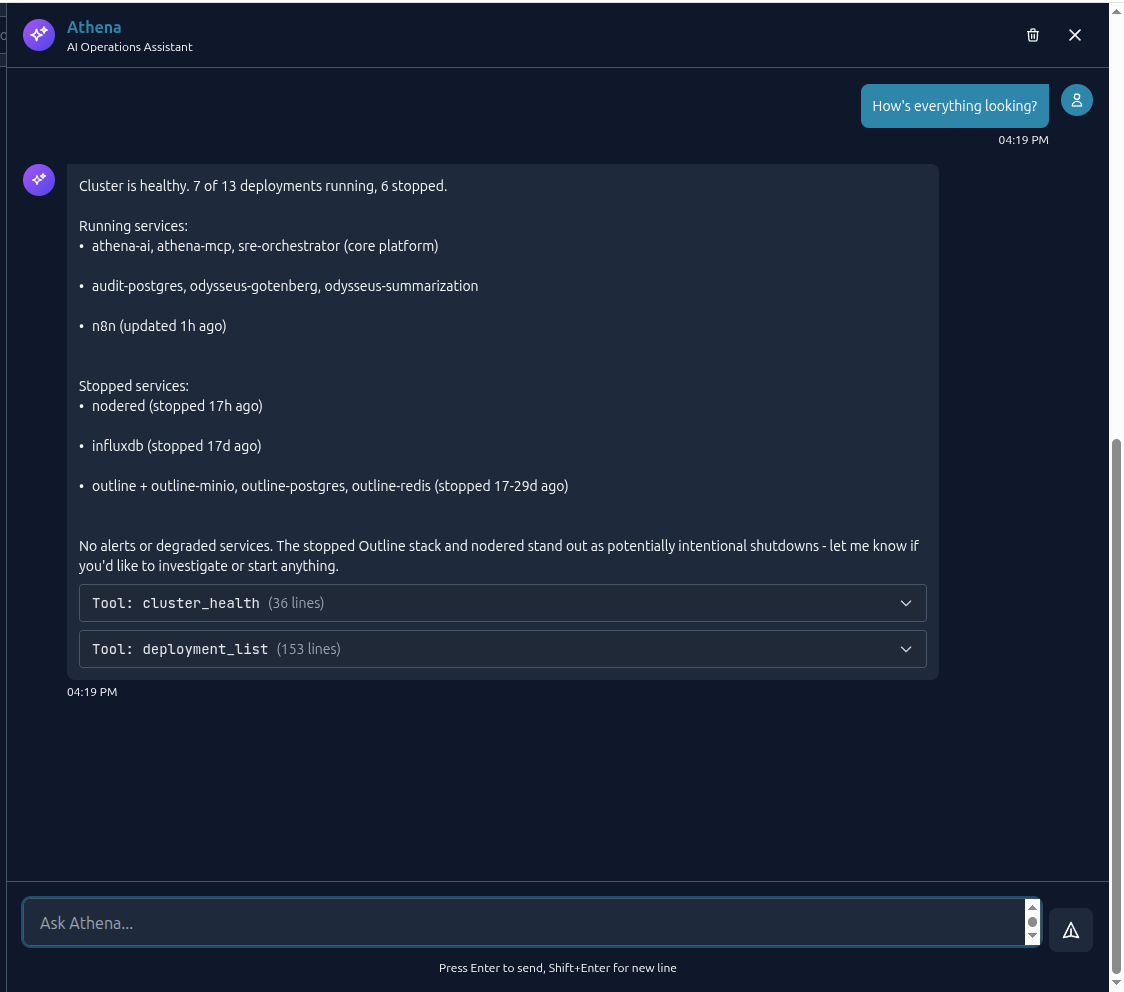
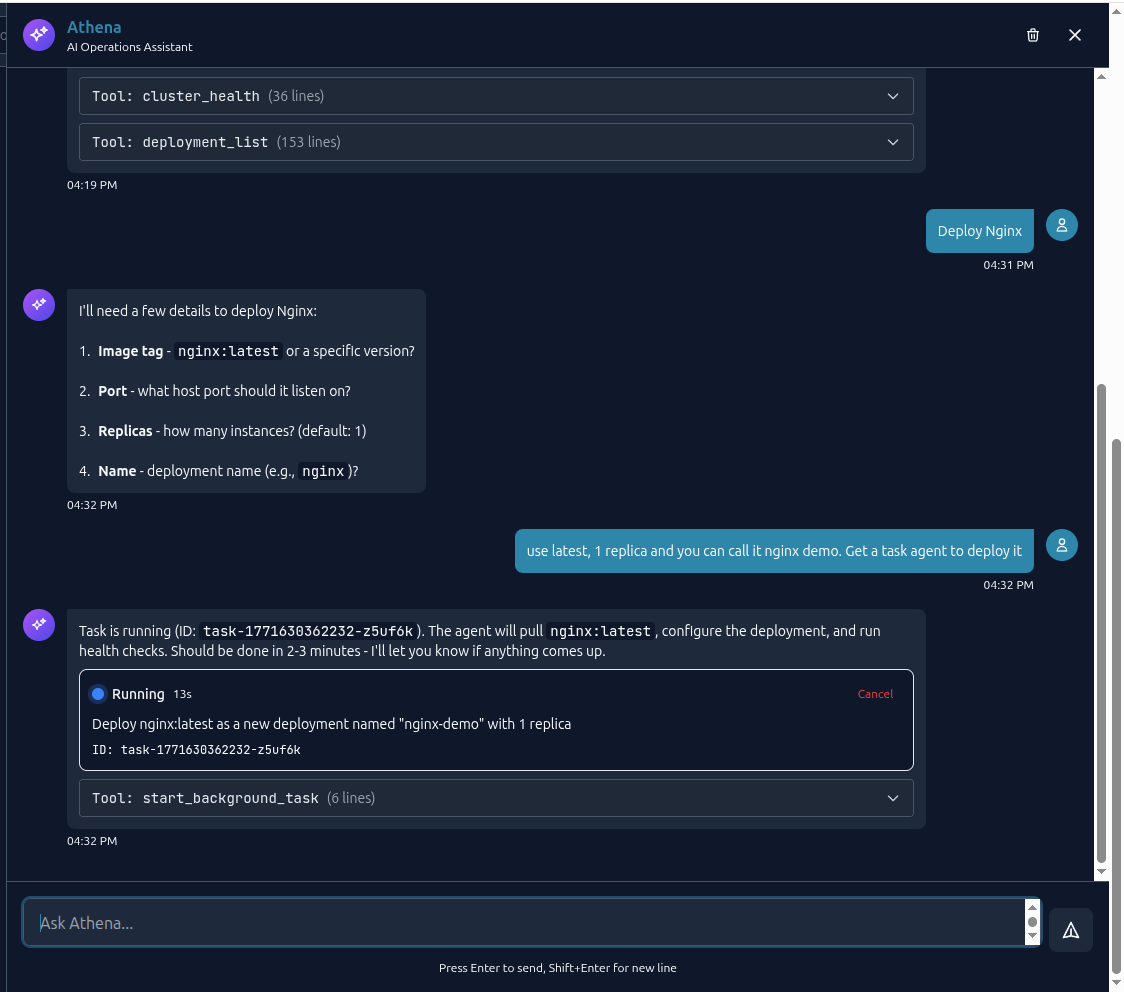
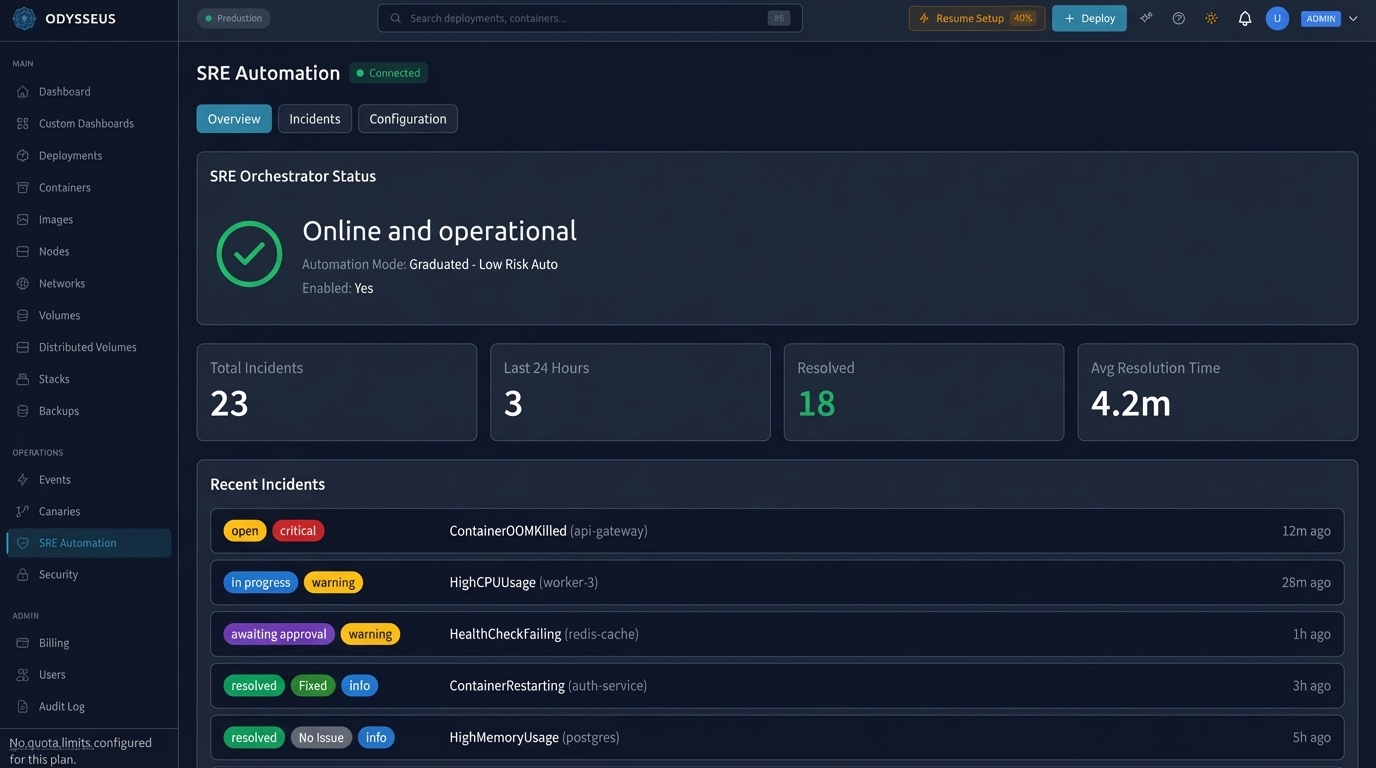
Orchestrateur SRE — infrastructure auto-réparatrice
Détectez les plantages de conteneurs, les arrêts OOM, les échecs de vérification d'état et les anomalies de performance en temps réel. Un LLM intégré diagnostique les causes profondes et exécute des remédiations sûres — avec une mise à jour progressive graduée et des garde-fous d'approbation humaine.
Analyse propulsée par LLM
Analyse IA multi-tours avec délais d'attente configurables, limites de jetons et invites système personnalisées. Le LLM enquête, diagnostique et propose des commandes — chacune étiquetée avec un niveau de risque.
Garde-fous configurables
Définissez le nombre maximum de commandes par incident, les périodes de refroidissement, les modèles de commandes dangereuses et les listes noires par service. Contrôlez quelles sévérités et niveaux de risque peuvent s'exécuter automatiquement.
Cycle de vie complet des incidents
Les incidents progressent à travers les états ouvert, en cours, en attente d'approbation, résolu, échoué ou escaladé — avec déduplication, corrélation et suivi de résolution (corrigé, rejeté, externe, aucune action requise).
L'outil adapté à 50–100 conteneurs par nœud — et au-delà
Odysseus est conçu pour le point où Docker Compose atteint ses limites et Kubernetes est plus d'appareillage que le travail n'en a besoin — et il continue de là. Nomad est le pair le plus proche dans ce tableau ; là où il nous égale ou nous dépasse, la ligne le dit.
| Capacité | Docker Compose | Odysseus | Kubernetes | Nomad[5] |
|---|---|---|---|---|
| Mise à l'échelle automatique | Piloté par Prometheus | Configuration complexe | Agent d'autoscaling séparé | |
| Déploiements sans temps d'arrêt | Mise à jour progressive update bloc |
|||
| Déploiements canari | Promotion automatique + restauration | Via Istio/Argo | Promotion automatique + réversion automatique | |
| Retour arrière instantané | Réversion vers la dernière version stable | |||
| RBAC | 4 rôles intégrés | RBAC complexe | Politiques et rôles ACL | |
| Piste d'audit | Intégré — chaîné par hachage, vérifiable indépendamment | Via add-on | Enterprise only | |
| Injection de secrets Vault | Lu depuis Vault à la création, jamais stocké | Via sidecar | Répertoire de secrets natif tmpfs | |
| Résidence des données géographiques | Filtre de placement, par pays ou région ISO[1] | Via l'affinité de nœud sur des labels personnalisés | Contraintes de région et de centre de données | |
| Isolation des locataires | Les nœuds sont inscrits auprès d'un locataire | Espaces de noms ; les nœuds sont portée du cluster | Espaces de noms ; les nœuds sont partagés | |
| Conteneurs multi-réseaux | Limité | Natif | Via le plugin CNI | Un network_mode par tâche |
| RAM du plan de contrôle | Aucun — CLI uniquement | 47–65 Mo mesurés | 2 Go minimum par machine[2] | 8–16 Go par serveur, trois ou cinq serveurs |
| RAM agent par nœud | Aucune — CLI uniquement | ~28 Mo mesurés | 275 Mo mesurés sur K3s ; 574 Mo – 1,9 Go réservés par les fournisseurs gérés[3] | Aucun chiffre publié |
| Courbe d'apprentissage | Heures | Jours | Mois | Jours |
| Assistant d'opérations IA | Athena (84 outils)[6] | |||
| Analyse CVE | Trivy + Grype | Via add-on | Via add-on | |
| Réponse automatique aux incidents | SRE propulsé par l'IA | Via add-on | Politiques de redémarrage et de replanification | |
| Personnel dédié de la plateforme | 0 | 0 | 1–2 ingénieurs | Vous gérez les serveurs vous-même |
| Conteneurs par nœud | 1–20 conteneurs | 50–100+ conteneurs[4] — le total de la plateforme augmente avec le nombre de nœuds | 110 pods par nœud[4] — un pod contient un ou plusieurs conteneurs | Aucune limite publiée — environ 330 par client dans leur propre exécution de deux millions de conteneurs |
Comment ces chiffres et affirmations ont été obtenus
-
La résidence géographique des données est un filtre de placement, et elle est livrée désactivée.
Un déploiement porte
odysseus.io/data-residency-country— un code ISO 3166-1 alpha-2 tel queCAouDE— ouodysseus.io/data-residency-region, qui nomme un ensemble défini par l'opérateur de ces codes, ouodysseus.io/blocked-countries. L'ordonnanceur compare chaque valeur aux étiquettes de pays et de région du nœud avant de placer quoi que ce soit, et un nœud qui ne satisfait pas l'exigence est retiré de l'ensemble des candidats — ainsi le déploiement ne peut pas atterrir en dehors de sa géographie permise, plutôt que d'y être trouvé ensuite. Elle est activée par installation dans la configuration du plan de contrôle et est désactivée par défaut ; les régions sont les définitions propres de l'opérateur, pas les nôtres. Kubernetes peut exprimer la même contrainte : il livretopology.kubernetes.io/regionettopology.kubernetes.io/zonecomme étiquettes de nœud bien connues, et l'affinité de nœud pour sélectionner sur elles, mais pas d'étiquette de pays ou de résidence propre — donc la résidence y est assemblée à partir d'étiquettes personnalisées et de règles d'affinité — kubernetes.io. La différence réside dans l'endroit où le concept vit, pas dans la possibilité de le faire. Nomad n'a pas besoin d'un tel assemblage et cette ligne n'est pas un différenciateur contre lui : region et datacenter sont des citoyens de premier plan dans son architecture, et un job contraint le placement sur${node.datacenter},${node.region}ou toute valeur${meta.<key>}définie par l'opérateur. Ce qui diffère là-bas est le vocabulaire plutôt que la puissance — le nôtre est une étiquette de résidence nommée portant des codes pays ISO et l'appartenance à une région, le leur une contrainte à usage général pointée vers ce que l'opérateur a écrit sur le nœud. -
Les chiffres de mémoire d'Odysseus sont mesurés, pas modélisés. Les deux correspondent à la mémoire résidente (RSS) du processus en cours d'exécution, échantillonnée sur une fenêtre de 14 minutes le 20 août 2026 sur deux installations en direct : production (plan de contrôle 47–51 Mo sur 19 échantillons, agent de nœud 26–28 Mo) et développement (plan de contrôle 49–64 Mo sur 18 échantillons, agent de nœud 26–28 Mo). Le plan de contrôle s'exécute une fois par installation ; l'agent s'exécute une fois par nœud. Le plan de contrôle publie lui-même le chiffre en tant que
process_resident_memory_bytessur son point de terminaison Prometheus/metrics, afin qu'il puisse être vérifié directement plutôt que cru sur parole. Nous citons la RSS plutôt quedocker statscar ce dernier inclut le cache de pages récupérable, qui sur un conteneur fraîchement démarré affiche une valeur plusieurs fois supérieure sans qu'aucune n'appartienne à l'orchestrateur. Le chiffre pour Kubernetes est le minimum documenté dans le guide d'installation kubeadm en amont : « 2 Go ou plus de RAM par machine » — kubernetes.io. -
Comparaison par nœud. Kubernetes en amont ne publie aucune réserve par défaut pour ses agents de nœud —
kubeReservedetsystemReservedfournissent tous deux une valeur vide — il n'y a donc pas de chiffre officiel unique à citer. Le chiffre profilé est le profilage des ressources K3s publié par SUSE, qui place les composants Kubernetes sur un nœud agent (travailleur) — selon ses termes, « le kubelet et l'agent k3s » — à 275 Mo sur un Intel 8375C, à partir de lectures au 95e percentile en régime permanent — docs.k3s.io. K3s est un binaire unique fusionné avec son propre runtime intégré, ceci constitue donc un minimum pour Kubernetes en amont exécutant les mêmes composants en tant que processus distincts, et non un équivalent. Les chiffres réservés représentent une capacité que les fournisseurs gérés retiennent sur chaque nœud travailleur avant qu'un conteneur d'application ne soit planifié, calculée à partir de leurs propres formules publiées : AWS EKS réserve(11 × max-pods) + 255Mio (574 Mio sur un m5.large, qui supporte 29 pods) — docs.aws.amazon.com ; Google GKE réserve 25 % des premiers 4 Gio et 20 % des 4 Gio suivants plus 100 Mio (≈1,9 Gio sur un nœud de 8 Gio) — cloud.google.com. La capacité réservée est une allocation que le planificateur retient, et non une consommation mesurée ; nous l'étiquetons comme telle car les deux ne sont pas la même chose. - Les nombres de conteneurs sont par nœud, et le nôtre est une déclaration d'adéquation, pas une limite. La plage décrit où Odysseus est conçu pour se situer — au-dessus du point où Docker Compose atteint ses limites, en dessous du point où Kubernetes justifie sa complexité. Il s'agit d'un positionnement, pas d'un résultat de benchmark, et nous ne le présentons pas comme tel. Un total de plateforme est ce chiffre par nœud réparti sur l'ensemble des nœuds qu'un plan de contrôle gère — une conséquence architecturale, pas quelque chose que nous avons mesuré à l'échelle de la flotte, nous ne publions donc pas non plus de chiffre pour la flotte. Le chiffre de Kubernetes est le plafond documenté par ce projet lui-même pour un cluster pris en charge : « Pas plus de 110 pods par nœud », énoncé aux côtés de « Pas plus de 5 000 nœuds » et « Pas plus de 300 000 conteneurs au total » — kubernetes.io. Les deux colonnes ne comptent pas la même unité — Kubernetes limite les pods, un pod contient un ou plusieurs conteneurs, et nous comptons les conteneurs — lisez-les donc comme adjacents plutôt que interchangeables. Nous ne faisons pas de conversion entre eux, car le ratio dépend de la manière dont les pods sont construits. Les distributions gérées imposent des limites encore plus basses : AWS EKS dérive la limite de pods par nœud à partir des interfaces réseau de la machine plutôt que de ce chiffre documenté, et son propre exemple détaillé est de 29 pods sur une machine à deux vCPU — le document cité dans la note 3. Nomad ne publie aucune limite par nœud, c'est pourquoi sa cellule l'indique plutôt que d'afficher un chiffre. La plus grande exécution que HashiCorp publie est sa propre démonstration : 2 000 000 de conteneurs répartis sur 6 100 clients — le terme de Nomad pour un nœud exécutant son agent — dans 10 régions AWS, planifiés en 22 minutes par trois serveurs — hashicorp.com — soit une moyenne d'environ 330 conteneurs par client. Il s'agit d'une démonstration plutôt que d'une limite prise en charge, et c'est un nombre plus grand que tout ce que nous avons exécuté.
-
La colonne Nomad est sourcée, et elle remporte plusieurs lignes. Nomad est le
pair le plus proche d'Odysseus dans ce tableau — un unique binaire, léger en ressources, et conçu pour
s'intégrer avec le même Consul sur lequel cette plateforme fonctionne — donc un cadrage qui fonctionne contre Kubernetes
serait injuste ici, et nous n'en avons pas utilisé un.
Les mises à jour progressives, les canaris avec
auto_promote, le retour automatique d'un déploiement échoué et le retour au dernier job stable sont tous dans le blocupdatede la spécification du job dans l'Édition Communautaire — developer.hashicorp.com. L'autoscaling est réel, et arrive sous la forme d'un second démon à exécuter : le Nomad Autoscaler est « construit et publié séparément de Nomad », couvre la mise à l'échelle horizontale des applications et du cluster, et lit Prometheus parmi ses sources de métriques — developer.hashicorp.com. La gestion des secrets est au moins notre égale : le répertoiresecrets/d'une tâche est soutenu par un système de fichiers en mémoire et monténoexec— developer.hashicorp.com. Les politiques et rôles ACL sont dans l'Édition Communautaire. Ce qui ne l'est pas : la journalisation d'audit, les quotas de ressources et la politique Sentinel sont dans Nomad Enterprise, tout comme le déploiement d'un job sur des régions fédérées — la fédération des régions elles-mêmes ne l'est pas — developer.hashicorp.com. Les espaces de noms sont dans l'Édition Communautaire, et ils segmentent les jobs, les allocations, les déploiements et les évaluations ; la documentation est explicite sur le fait que « Nomad ne met pas en espace de noms les objets partagés entre plusieurs espaces de noms. Cela inclut les nœuds » — developer.hashicorp.com. Kubernetes trace la même ligne — « les ressources de bas niveau, telles que les Nœuds … ne sont dans aucun espace de noms » — kubernetes.io; sur cette plateforme, un nœud est inscrit à un locataire, ce que cette ligne enregistre. Le chiffre des serveurs est l'architecture de référence propre à HashiCorp — « Un cluster Nomad comprend typiquement trois ou cinq serveurs », avec 2 à 4 cœurs et 8 à 16 Go de mémoire chacun pour un petit déploiement de production — developer.hashicorp.com. Il s'agit d'un dimensionnement machine qu'un lecteur devrait traiter de la même manière que nous traitons le chiffre Kubernetes dans la note 2 : une recommandation, pas une mesure de mémoire processus. Nous n'avons trouvé aucun chiffre publié pour l'agent client, donc la colonne indique qu'il n'y en a pas plutôt que d'en deviner un, et la ligne sur la courbe d'apprentissage est notre estimation plutôt que la mesure de quiconque. -
Le nombre d'outils Athena est un nombre de sites d'appel, pas un nombre rond.
Il s'agit de
server.registerTool(sites d'appel dansathena-mcp/src/tools/*.ts— 80 au moment de la rédaction — avec deux corrections appliquées par-dessus : la pairecronjob_suspend/cronjob_resumeest enregistrée depuis un seul site d'appel à l'intérieur d'une boucle (un site, deux outils, donc +1), et les trois assistants de découverte (search_tools,describe_tool,request_tool) sont enregistrés séparément parmakeDiscoveryTools()dansserver.tsplutôt que par un appel correspondant à ce modèle (+3). 80 − 1 + 2 + 3 = 84. N'importe qui peut reproduire le chiffre de base avecgrep -rc "server.registerTool(" athena-mcp/src/tools/*.tssur la version taguée et redériver le même total à partir des deux corrections ci-dessus.
Tarification simple et transparente
Frais de base + tarification par nœud qui évolue avec vous. Commencez gratuitement, passez à la version supérieure à mesure que vous grandissez.
Pour les développeurs indépendants, les laboratoires domestiques et l'évaluation.
- Jusqu'à 3 nœuds
- 1 utilisateur
- Compatibilité complète avec Docker Compose
- WireGuard maillage VPN
- Métriques Prometheus de base
- RBAC à 2 niveaux
- Support communautaire
- Pas d'Athena AI
- Pas d'analyse CVE
Pour les développeurs solo et les très petites équipes exécutant de petites charges de travail de production.
- Jusqu'à 5 nœuds
- Jusqu'à 3 utilisateurs
- Athena AI (100 requêtes/mois)
- Analyse CVE hebdomadaire
- Déploiements canari
- Injection de secrets Vault
- Automatisation SRE de base
- Piste d'audit de 30 jours
- Assistance par e-mail (SLA de 48 h)
Pour les charges de travail de production des PME. Le niveau commercial de base.
- Jusqu'à 50 nœuds
- Utilisateurs illimités
- Athena AI illimité
- Analyse CVE continue + validation de stratégie
- Promotion/rollback automatique complet du canary
- Autoscaling Prometheus
- Automatisation SRE complète (8 types d'incidents)
- RBAC complet à 4 niveaux
- Journal d'audit de 90 jours
- Support prioritaire (SLA 4h)
Pour les organisations multi-sites avec des exigences de conformité et de SLA personnalisées.
- Nœuds illimités
- Tout ce qui est inclus dans Pro
- Fonctionnement multi-cloud, multi-région à partir d'un seul plan de contrôle — voir la preuve
- SSO / SAML / LDAP / OIDC
- Journal d'audit d'un an
- Contrôles et preuves d'audit alignés sur SOC 2 et ITSG-33 — détail
- Remises sur volume (50+ nœuds)
- Gestionnaire de compte dédié
- SLA 1h + support d'astreinte 24/7
Les fournisseurs d'hébergement, les MSP et les agences exécutent de nombreux clients sur un seul plan de contrôle, avec la multilocation comme frontière réelle. La tarification pour cela est une conversation, pas une carte.
Delta Telematics est une entreprise canadienne, et ce site est publié en anglais, en français et en chinois simplifié. Vos nœuds sont les vôtres : les charges de travail, les volumes et les données qu'ils contiennent résident sur des serveurs que vous contrôlez, dans votre propre juridiction, tandis que le plan de contrôle détient l'état d'orchestration plutôt que les données de votre application. Les informations personnelles sont traitées conformément à la LPRPDE. L'application de la localisation géographique — ancrer une charge de travail à un pays ou une région au sein de votre propre flotte — est disponible et désactivée par défaut.
Commencez à orchestrer
en moins de 10 minutes.
Inscrivez-vous, connectez votre premier nœud et déployez — le tout en moins de 10 minutes. Aucune expertise Kubernetes, aucune équipe de plateforme dédiée.