L'orchestrateur SRE
Le problème
Section intitulée « Le problème »La plupart des incidents de production sont des répétitions d’un incident antérieur, et la plupart des vingt premières minutes sont consacrées aux mêmes quatre commandes : lire la sortie du conteneur, regarder son utilisation des ressources, vérifier ce qui a changé, vérifier si c’est uniquement celui-ci. Ce travail est mécanique, il se produit à la pire heure possible, et le faire à la main est la raison pour laquelle la partie utile commence tard.
Ce que c’est
Section intitulée « Ce que c’est »Un service distinct qui surveille les problèmes, rassemble les preuves qu’une personne aurait recueillies, demande à un modèle de les lire, et transforme la réponse en un incident avec un remède proposé joint. Ce qu’il ne fait pas par défaut, c’est exécuter le remède.
Trois choses peuvent déclencher un incident :
- une alerte de la pile de surveillance ;
- un changement que le service détecte sur les clés d’événements propres à la plateforme — un déploiement qui a échoué, une vérification d’état qui a échoué, une erreur d’application ;
- quelqu’un en demande un, depuis la console ou via l’outil d’incidents de l’assistant.
Les alertes répétées se fusionnent en un seul incident. Deux alertes sont le même incident lorsque leur nom, leur conteneur et leurs labels stables correspondent dans une fenêtre temporelle, de sorte qu’un conteneur redémarrant en boucle produit une seule chose à examiner plutôt que quarante.
Ce qui arrive à un incident
Section intitulée « Ce qui arrive à un incident »Il est d’abord attribué à un locataire. Le label est utilisé s’il en nomme un ; sinon le nœud d’où il provient est résolu au locataire qui possède ce nœud ; sinon il appartient à la plateforme. L’attribution a lieu avant toute chose, car tout ce qui suit est stocké et lu dans la portée d’un seul locataire.
Les preuves sont rassemblées : la sortie récente du conteneur, son utilisation des ressources, sa configuration, les événements récents autour de lui, les métriques de redémarrages et de saturation, et toute trace.
Un modèle lit les preuves et répond dans un format fixe : le niveau de risque, le type de résolution, les commandes proposées, et si une personne est requise. La proposition n’est jamais du texte libre sur lequel le service agit — c’est une réponse structurée avec un niveau de risque par commande.
Les garde-fous jugent ensuite chaque commande, et c’est là que l’automatisme s’arrête ou continue.
Une personne approuve, ou rien ne s’exécute. Un incident dont les commandes ont été bloquées attend une approbation. L’approuver relance ces commandes, et elles passent à nouveau par les mêmes vérifications de la liste de blocage — l’approbation contourne la phase de mise à jour progressive, pas la liste des commandes dangereuses.
Ce qui est autorisé à s’exécuter sans intervention humaine
Section intitulée « Ce qui est autorisé à s’exécuter sans intervention humaine »Par défaut, rien. Le service est livré dans la première des quatre phases de mise à jour progressive, et cette phase n’autorise aucun remède automatique à quelque niveau de risque que ce soit ; les phases suivantes ajoutent un risque faible, puis moyen, puis élevé. En plus de la phase, il y a sept vérifications supplémentaires : une liste de conteneurs bloqués, une liste d’alertes bloquées (une base de données en panne et une alerte de perte de données en font partie par défaut), une liste de motifs dangereux comparée au texte de la commande, un filtre de sévérité, un filtre de risque, une limite de trois commandes par incident par heure, et un délai de retrait entre les remèdes pour la même empreinte.
Deux choses à ce sujet méritent d’être dites clairement plutôt que laissées à la découverte.
Les commandes de diagnostic ne sont pas liées à une phase. Lorsque l’analyse conclut qu’il n’y a pas de problème ou que la cause est externe, les commandes de diagnostic qu’elle a proposées sont exécutées pour le confirmer, dans chaque phase, y compris la première. Elles restent soumises à la liste des modèles dangereux.
Une commande est une commande shell. Il n’y a pas de liste de programmes autorisés et pas de bac à sable : ce qui se trouve entre une commande proposée et la machine est la liste de motifs et la phase. C’est un point de conception délibéré plutôt qu’un oubli — la valeur du service est qu’il peut exécuter ce qu’un ingénieur aurait exécuté — mais c’est la raison pour laquelle la phase de mise à jour progressive existe et la raison pour laquelle la valeur par défaut est de ne rien exécuter.
La phase réellement configurée n’est pas visible depuis la source. C’est un état défini par l’opérateur, édité depuis la console et stocké dans le magasin clé-valeur de la plateforme, et le service refuse de démarrer s’il est manquant. Pour savoir ce qu’un déploiement donné fera automatiquement, lisez sa configuration, pas cette page.
Un service, plusieurs locataires
Section intitulée « Un service, plusieurs locataires »Il y a un processus pour toute la plateforme, pas un par locataire. L’isolation se fait dans les données : chaque incident est stocké sous son locataire, chaque lecture et écriture est limitée à un seul, et le plan de contrôle supprime toute identité de locataire fournie par l’appelant avant de proxifier et injecte celle qu’il a vérifiée. Un opérateur de plateforme sans locataire sélectionné obtient une vue sur tous les locataires, et cet élargissement est enregistré dans un journal d’audit séparé plutôt que d’être silencieux.
La politique d’automatisation elle-même est à l’échelle de la plateforme. Les garde-fous, la phase de mise à jour progressive et les paramètres de notification se trouvent à une clé et sont modifiés par un opérateur de plateforme ; chaque locataire fonctionne sous la même politique. Une politique par locataire n’existe pas.
Qui peut faire quoi
Section intitulée « Qui peut faire quoi »Lire les incidents nécessite une permission, approuver ou en rejeter un en nécessite une autre, en déclencher un en nécessite une troisième, et modifier la configuration en nécessite une quatrième ainsi qu’un statut d’opérateur de plateforme par-dessus. La liste complète, avec les rôles qui détiennent chaque permission, se trouve dans la référence des rôles.
Not this
Cette page ne vous indique pas comment exécuter le service ni quelle phase de mise à jour progressive définir ; c’est une décision opérationnelle avec une réponse par déploiement.
Deux choses sont délibérément non affirmées ici car la source ne peut pas les trancher. Les mises à jour en direct de la console sont poussées du service vers une adresse du plan de contrôle qui est enregistrée derrière une authentification et une permission, tandis que le propre client du service n’envoie aucune information d’identification et traite un échec comme un avertissement enregistré — si cette poussée réussit dans un déploiement donné est une question pour ce déploiement, pas pour cette page. Et les incidents sont stockés dans le magasin clé-valeur de la plateforme sous une purge de rétention mesurée en jours ; ils ont été le plus grand consommateur unique de ce magasin, et aucun déchargement d’eux n’existe encore.
Parcours d’un incident sur le tableau de bord
Section intitulée « Parcours d’un incident sur le tableau de bord »Ouvrez SRE Automation dans la barre latérale (section Operations). Un incident ouvert affiche sa
sévérité, le locataire auquel il appartient et les garde-fous de sécurité qui contraignent ce qu’il est autorisé
à faire automatiquement — voir sre-orchestrator/app/safety_guardrails.py. Approuver une remédiation
nécessite la permission sre:approve ; modifier ce que le plan de contrôle est autorisé à faire sans surveillance
nécessite sre:configure. Consultez le guide de tâche pour en approuver une.
Où le voir
Section intitulée « Où le voir »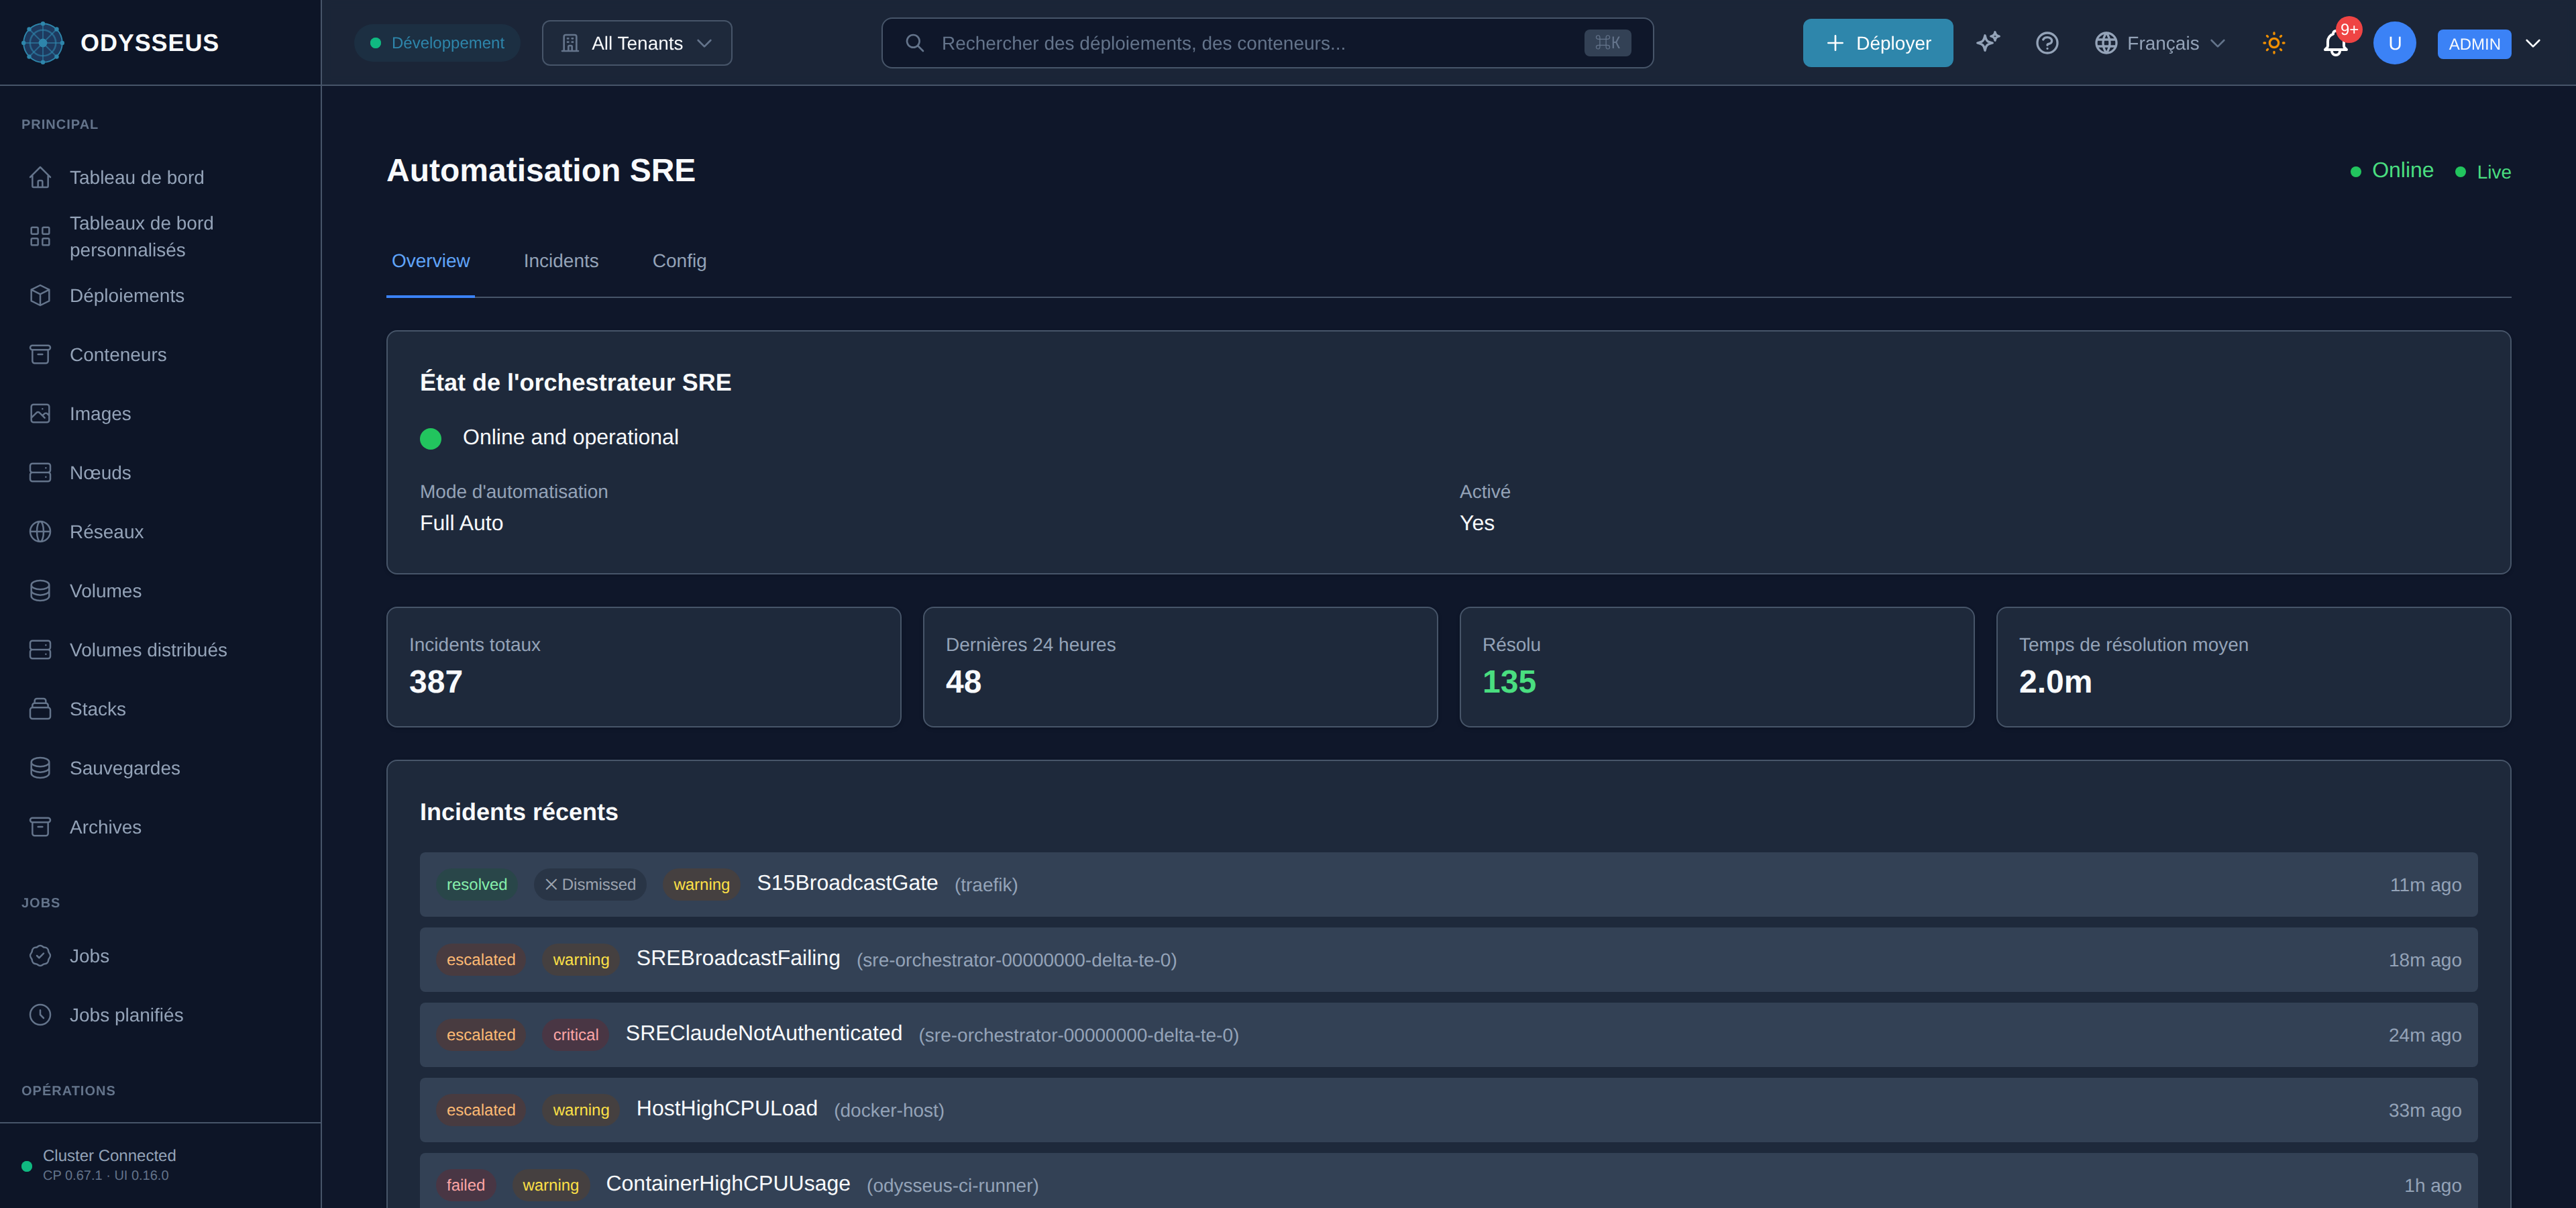
- Chaque permission et les rôles qui la détiennent : référence des rôles.
- Pourquoi un conteneur redémarrant en boucle est un incident : santé et nettoyage.