容器启动,停止,然后再次启动
Symptom
部署的重启次数增加。日志显示应用程序的前几行,然后什么都没有,反复如此。状态在运行和未运行之间闪烁。
Diagnose
- 首先读取容器自身的输出。 仪表板的日志视图,或
odysseus logs <deployment>。因缺少环境变量或数据库不可达而退出的应用程序会说明原因,任何平台侧的检查都无法更好地说明。 - 是否因内存被终止? 容器的事件包含终止原因。达到内存限制是终止,而非崩溃,应用程序的日志会在句子中间结束,而不是以错误结束。
- 健康检查是否在终止它? 反复失败的探测会被视为失败的容器。在镜像内部运行探测命令本身,看看它做了什么——一些镜像不包含探测命令所针对的工具。
- 镜像是否是您想要的? 移动的标签会产生一个从未工作过的容器,这看起来与一个损坏的容器完全相同。
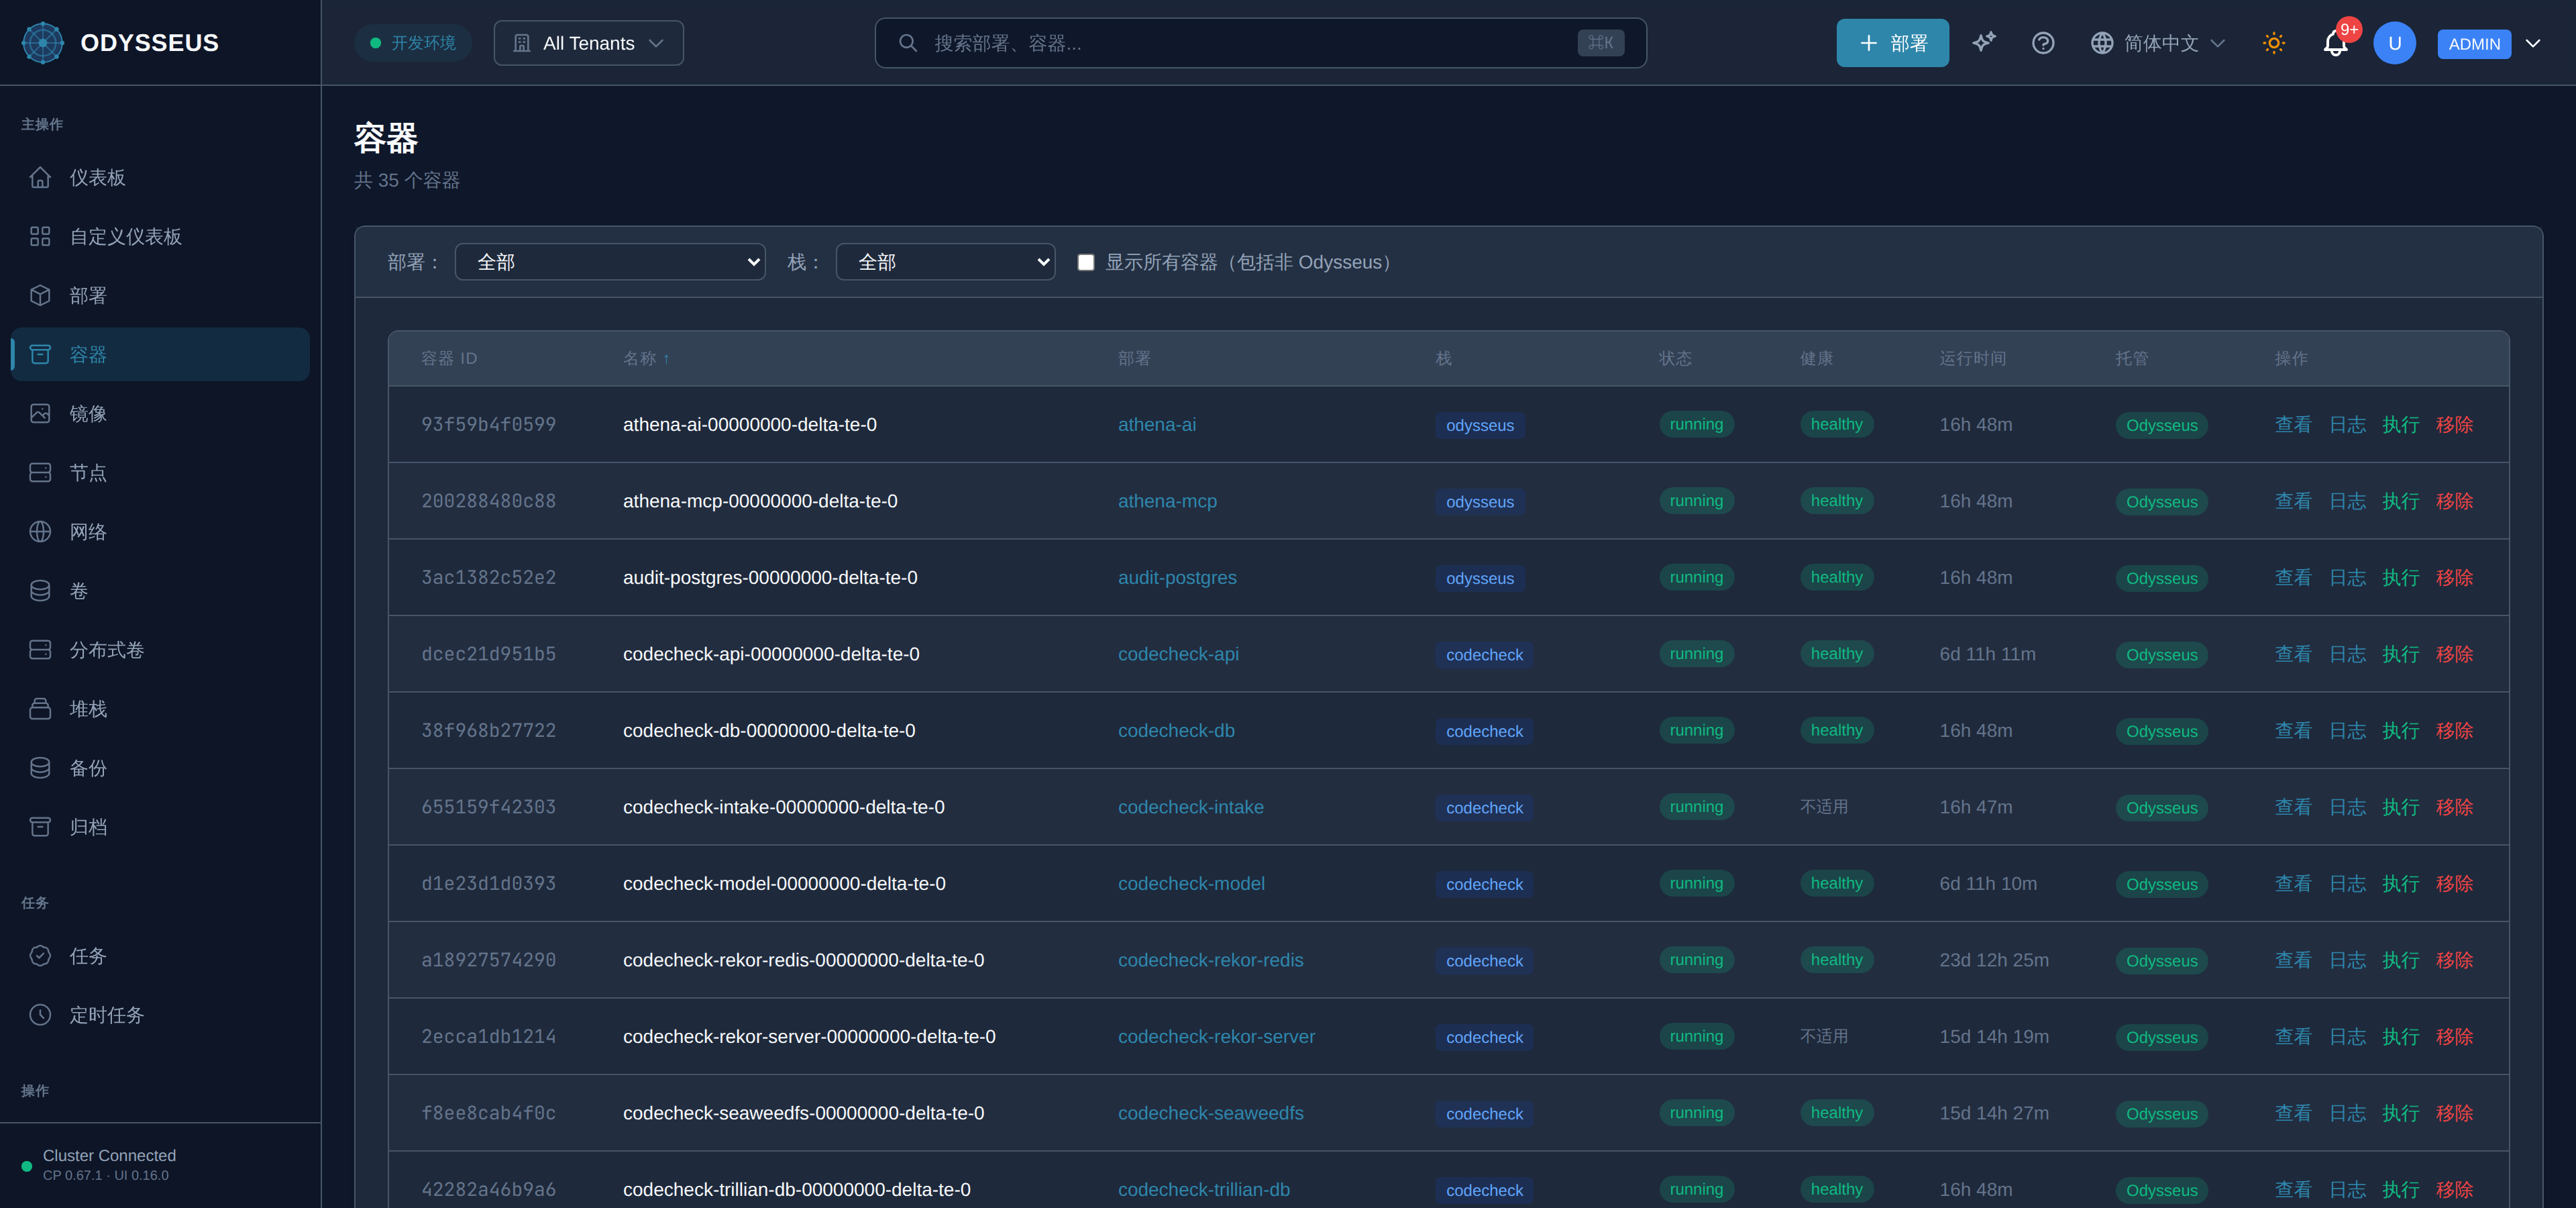
- 它是在重启,还是被替换? 重启的容器会保留其 ID。平台替换的容器会有一个新的 ID。当部署的规格不再与该容器构建时的规格匹配,或者标签背后的镜像移动时,平台会替换容器——因此一系列新 ID 意味着部署正在被反复调谐,修复方法在于不断重写部署的内容,而非镜像。仅更改副本数不是此类更改,不会影响正在运行的容器。
- 它是否停止且从未恢复? 那么读取事件,
GET /api/v1/events。在节点上找到但没有对应部署记录的容器会被移除,而不仅仅是报告,移除操作会作为orphan.deleted发布。清理每十五分钟运行一次,仅处理已停止的容器,并且只有在第二次读取确认记录不存在、能够看到整个节点以及容器指明了其所有者之后才会执行。所有这些拒绝也会被发布,作为orphan.deletion_refused——因此无论是移除还是决定保留它,都不是静默的。
Resolve
- 应用程序错误: 在镜像中修复它,或提供它缺少的内容。由配置引起的重启循环应通过配置修复,而非重启。
- 内存终止: 提高限制,或减少应用程序持有的内容。更改限制会替换容器,这是预期行为——部署参考的可变性列说明了哪些字段会这样做。
- 探测失败: 修正命令以便镜像可以运行它,或故意抑制继承的探测。参见健康检查与进程回收。
- 错误的镜像: 固定标签。未固定的标签在创建时会因此被拒绝。
- 被替换而非重启: 找出不断更改部署的原因。替换是平台执行部署当前要求的操作;镜像中的任何内容都无法阻止它。
- 作为孤立容器被移除: 容器比其部署记录存活更久。通过 API 重新创建部署,平台会放置它;不要手动启动容器,因为下次清理会发现它无主并再次将其移除。
Prevent
固定镜像标签,并编写一个使用镜像实际携带的工具的探针。两者故障在预防上成本低廉,但在负载下诊断成本高昂,因为证据会滚动过去。