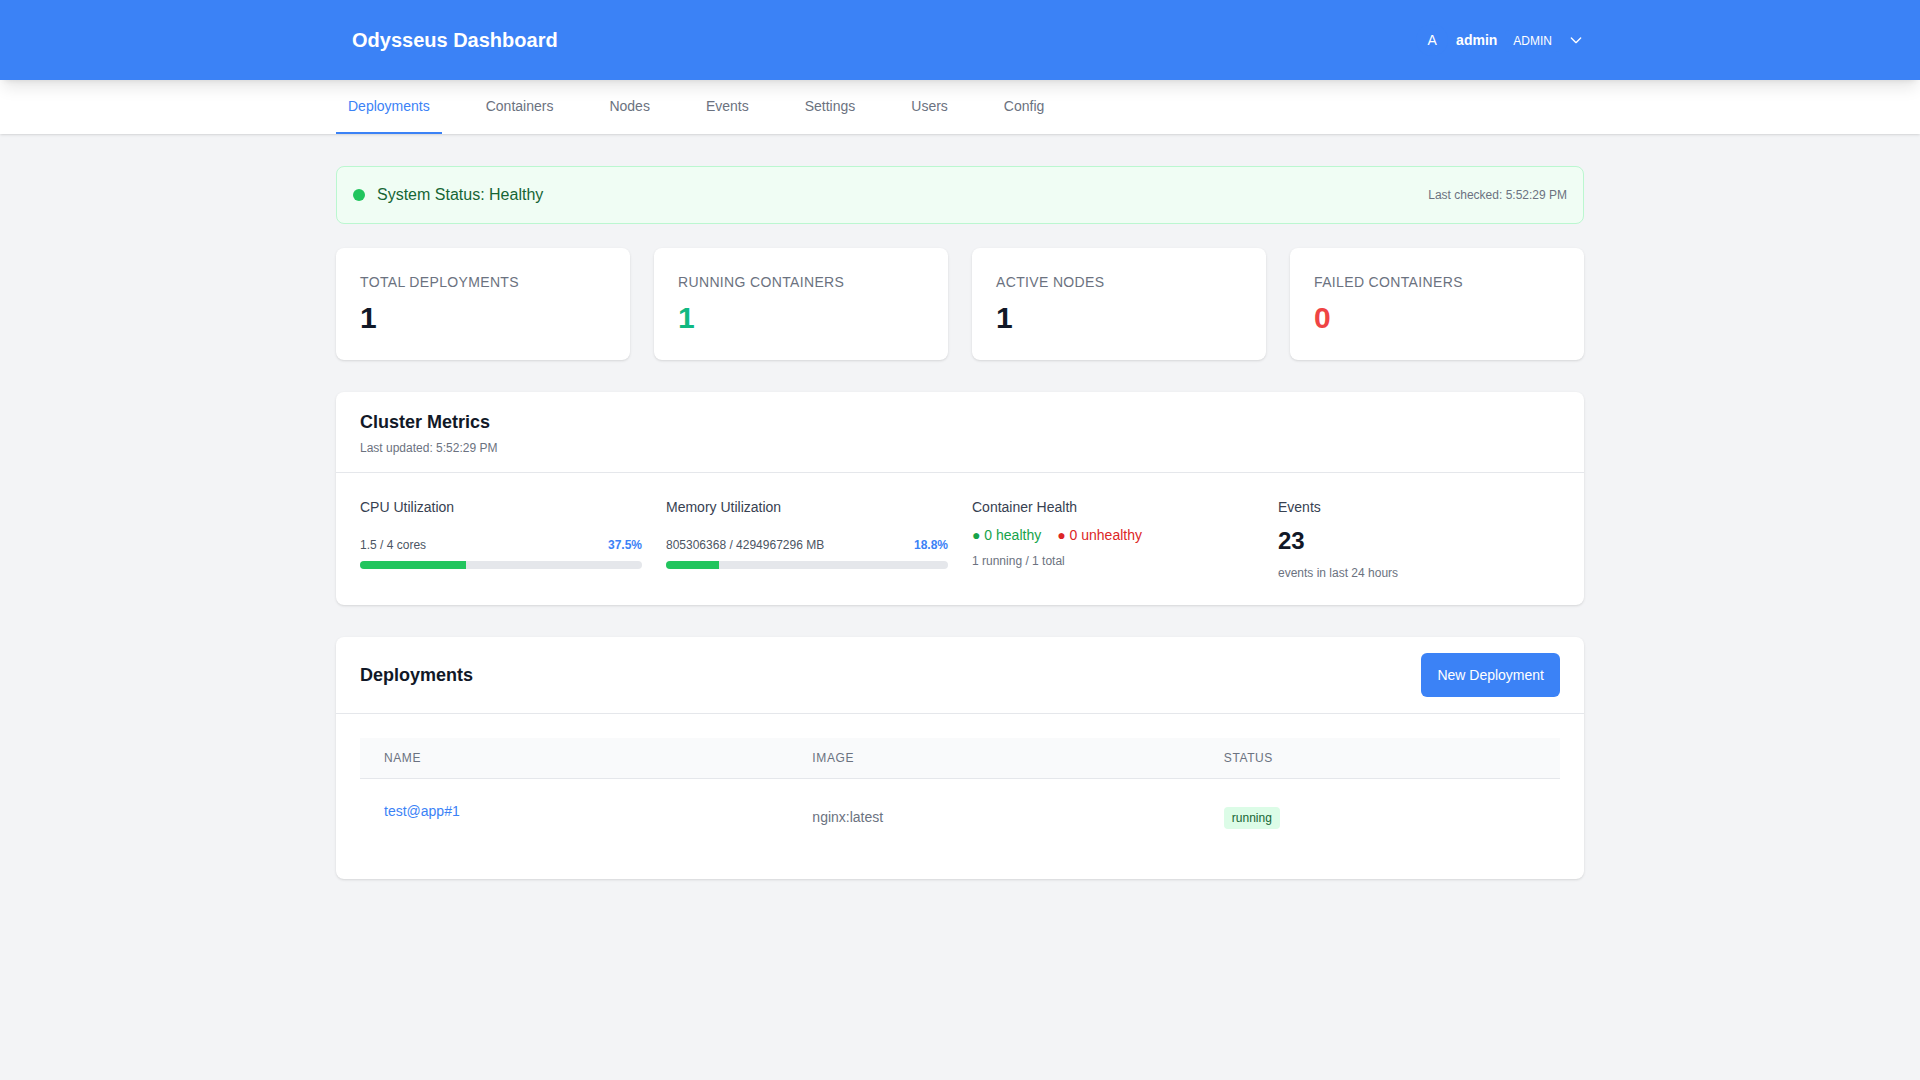
每个租户独立的 Vault 路径、每个租户独立的 Docker 网络,以及故障关闭的 Postgres 行级安全策略——而非一个可能被错误配置策略跨越的命名空间标签。
阅读测试它的审计报告在过于简单
和过于复杂之间左右为难?
管理 50 或 100 个容器不应需要专属的平台团队。 但也不应仅靠 shell 脚本勉强维持。
Docker Compose 的局限性
无自动扩缩容、无高可用性、无滚动部署。一次错误的推送就可能让您的整个服务宕机——而手动恢复会让团队无法专注于交付。
Kubernetes 过于复杂
文档要求每台机器至少 2 GB 内存、数月的准备时间、1-2 名专职工程师来维护。在这个规模下,您是在为那些永远用不全的功能支付企业税。
每一次部署都是一次风险
没有金丝雀发布意味着缺陷会瞬间影响 100% 的用户。没有审计追踪意味着您无法在合规审查或事后复盘中回答“何时更改了什么?”的问题。
- 30–60 分钟的手动部署步骤
- 一次错误的部署会导致 100% 的用户受影响
- 流量高峰时需手动扩容
- 无审计日志——无法回答“谁做了更改?”
- 密钥存储在环境变量或 bash 脚本中
- 从故障中恢复需要 15–30 分钟
- 每次部署自动化仅需 2–3 分钟
- 金丝雀发布在全面滚动更新前将缺陷暴露给10%的流量
- 基于Prometheus的自动伸缩,无需手动干预
- 包含操作者、时间戳和结果的完整审计跟踪
- 在创建时从Vault读取——绝不存储在Consul、清单或审计跟踪中
- 健康检查失败时即时自动回滚
注册、连接、部署
Odysseus是完全托管的。注册后,运行一行命令连接您的节点,即可开始部署——控制平面由我们负责。
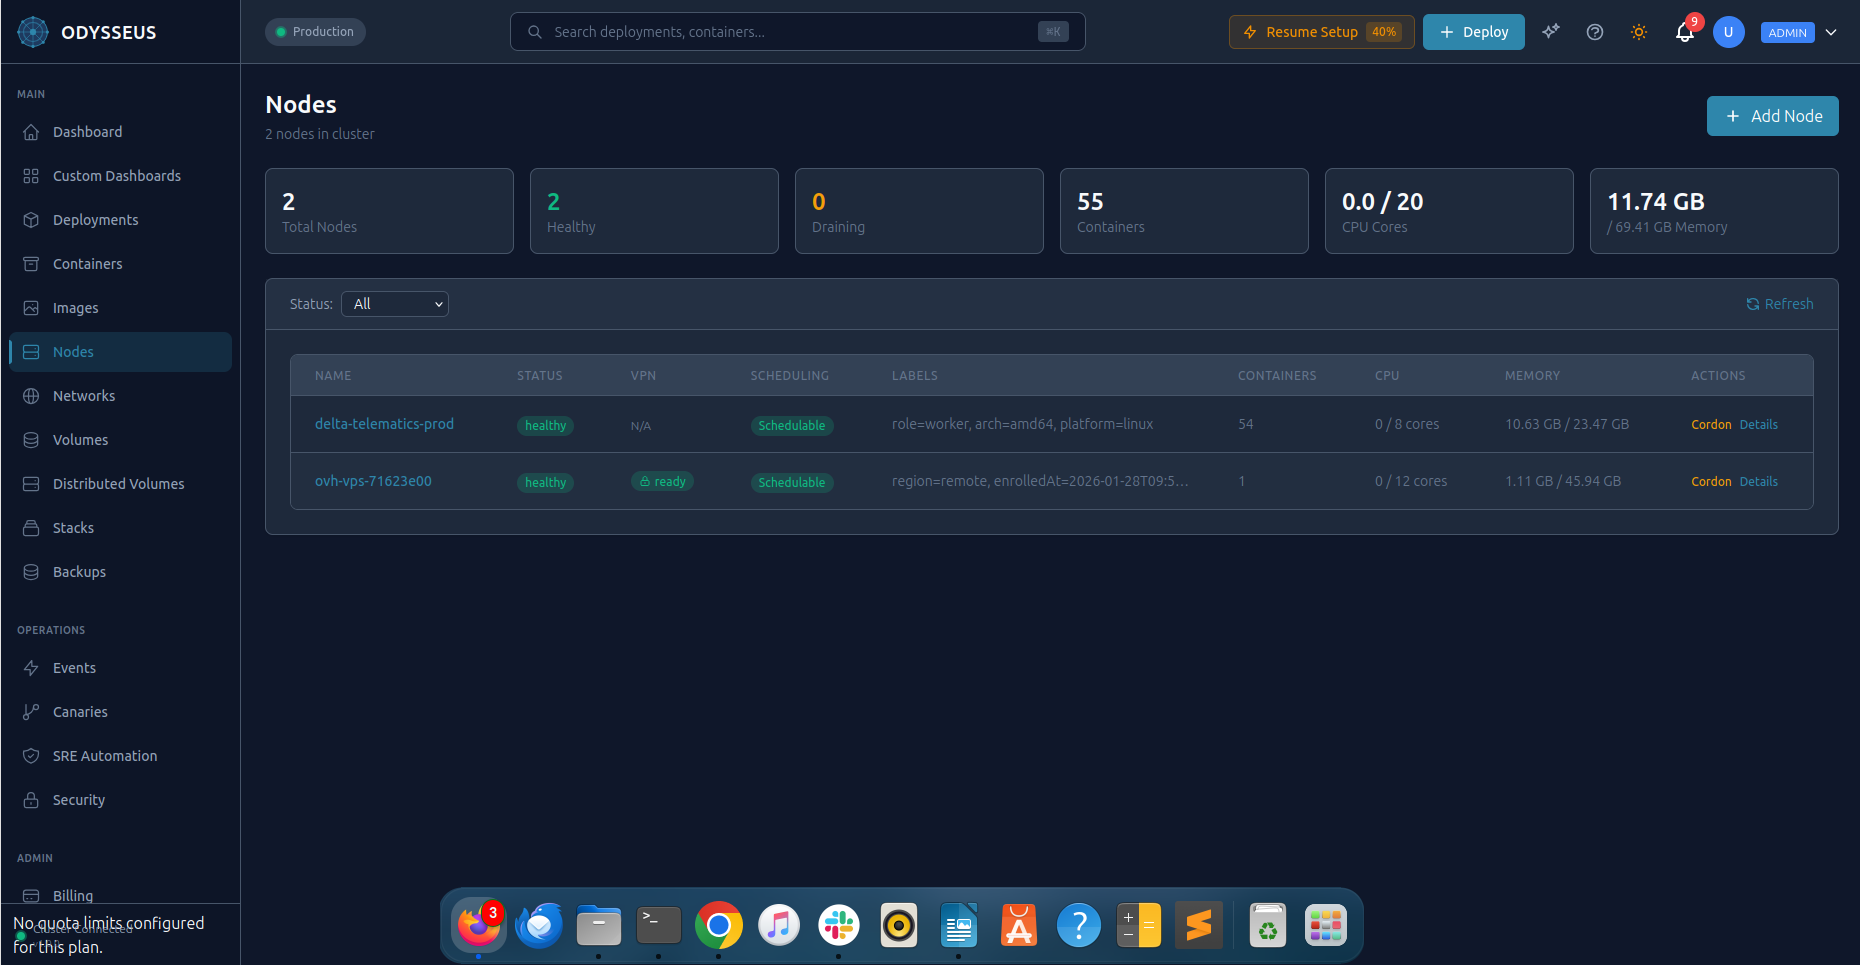
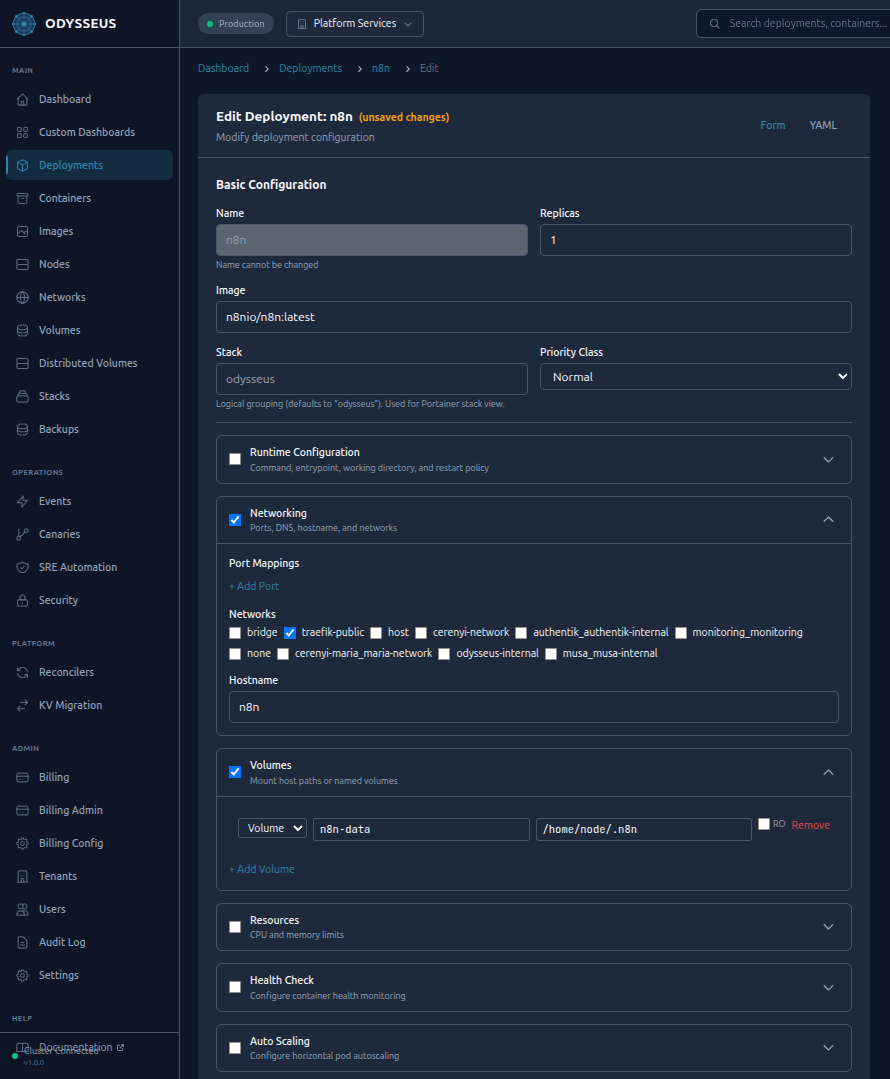
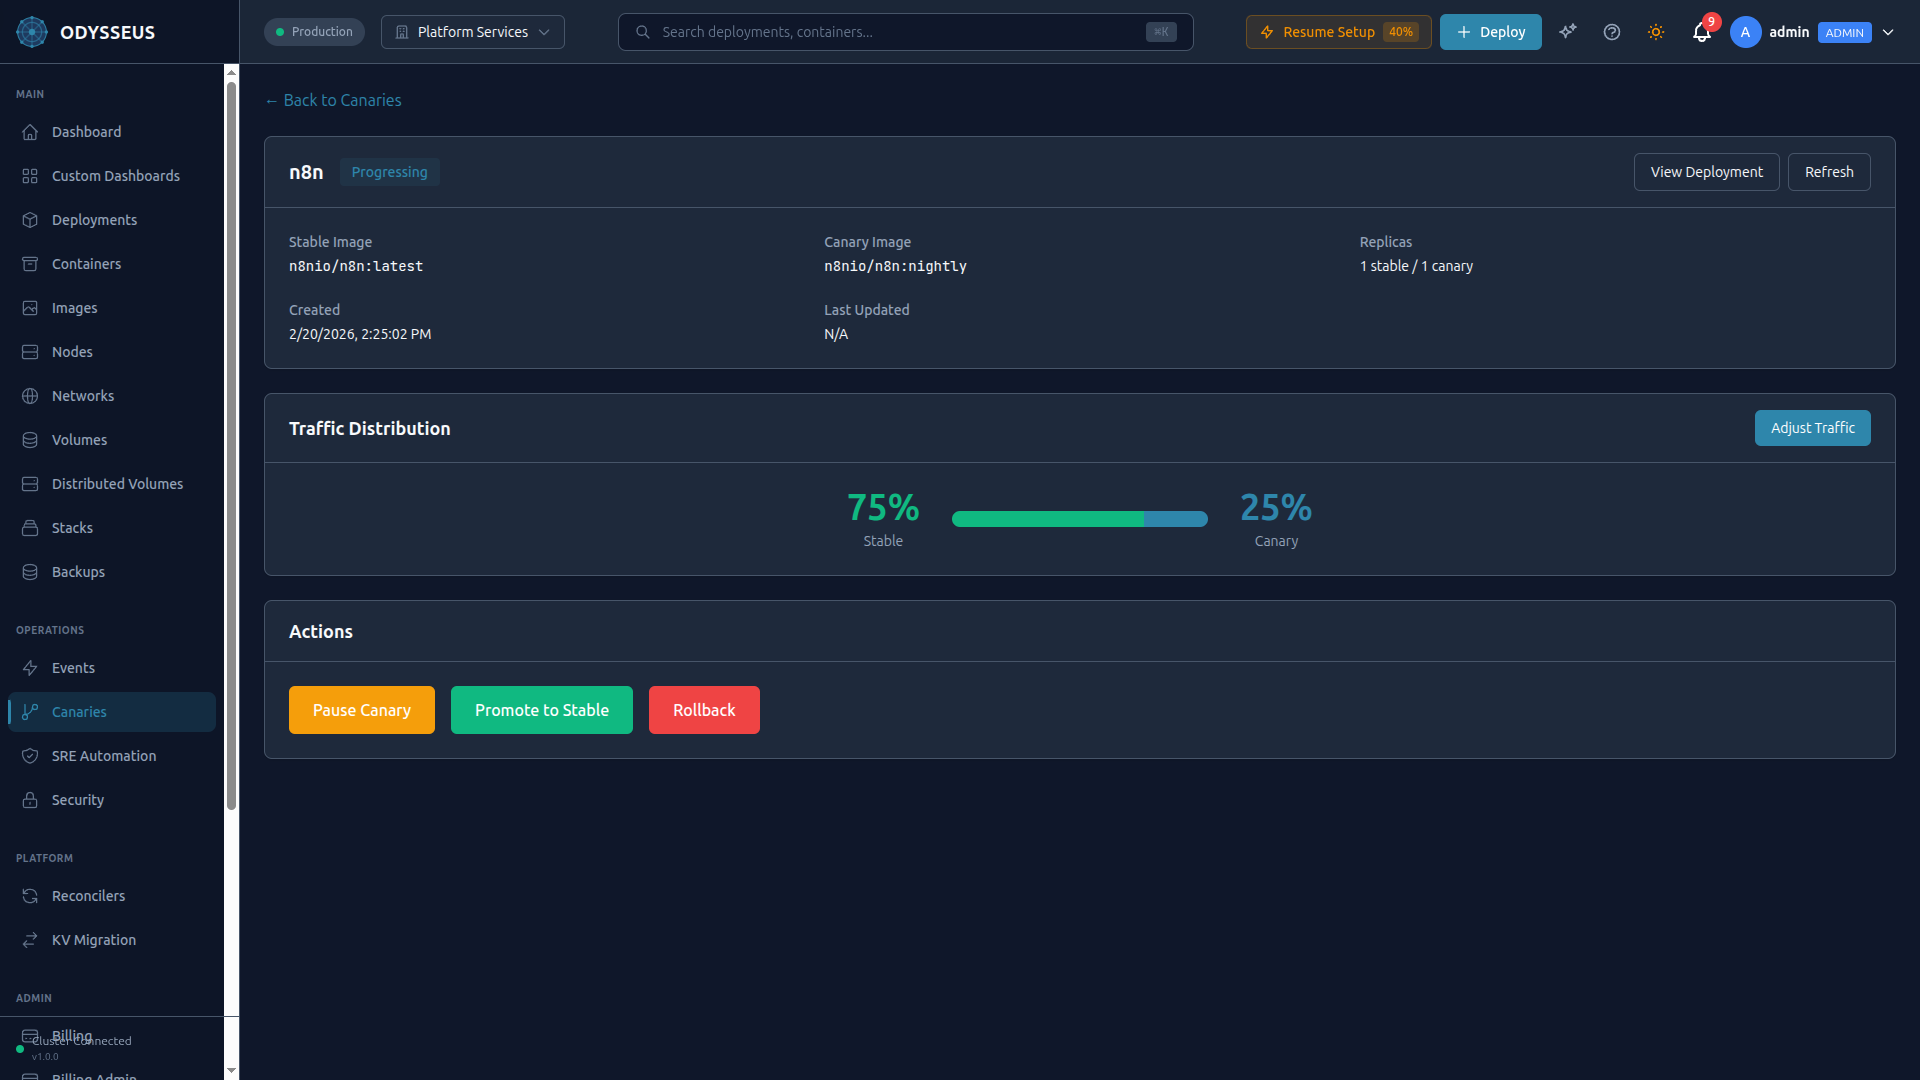
你需要的一切。
你不需要的,一样没有。
专为那些已超越Docker Compose,但又不想仅为运行容器而组建平台团队的团队而设计。
您已熟悉的 Docker Compose 语法
通过添加一个x-odysseus块来扩展现有的docker-compose.yml文件。无需学习新的DSL——您的团队从第一天起就能交付。
多网络容器附加
将容器同时连接到多个Docker网络——这是Nomad和许多其他编排器的关键限制,而Odysseus原生解决了这个问题。
四级 RBAC
开箱即用的管理员、操作员、开发者和只读角色。精确控制谁可以部署、扩展或仅进行观察——使用JWT + mTLS身份验证。
轻量级代理程序,零开销
Odysseus代理程序是一个单一的Go二进制文件,运行在您的节点上——在实时生产和开发节点上测量,常驻内存约为28 MB。几秒钟内即可安装,并通过健康检查门控的回滚实现自动升级。
自动化事件响应
Odysseus 实时检测容器崩溃、OOM 终止、重启循环和健康检查失败,然后自动执行修复。无需值班疲劳的自愈基础设施。
内置 CVE 扫描
使用 Trivy 和 Grype 进行双后端漏洞扫描。定义策略以自动阻止包含严重 CVE 的部署。获取基于严重性的优先级排序补丁建议。
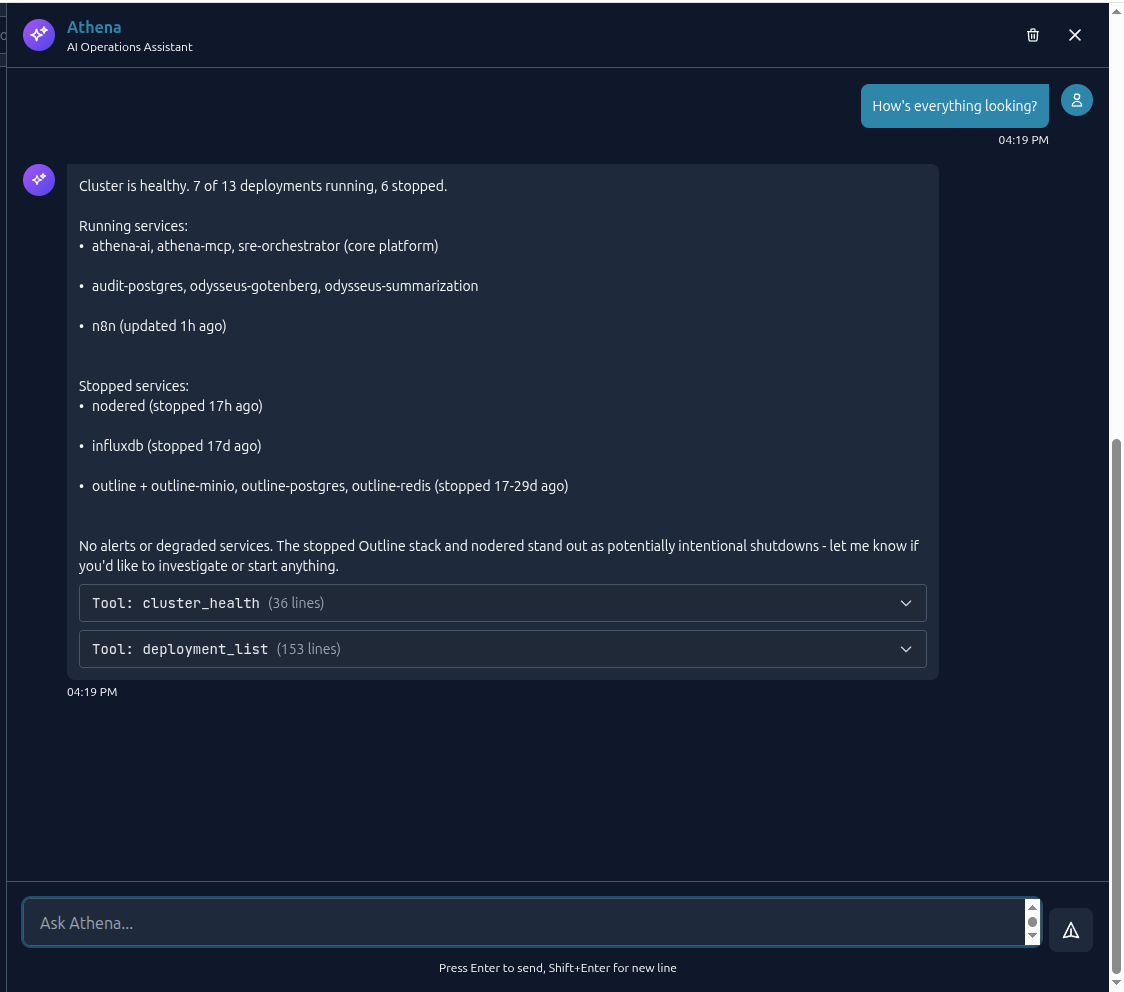
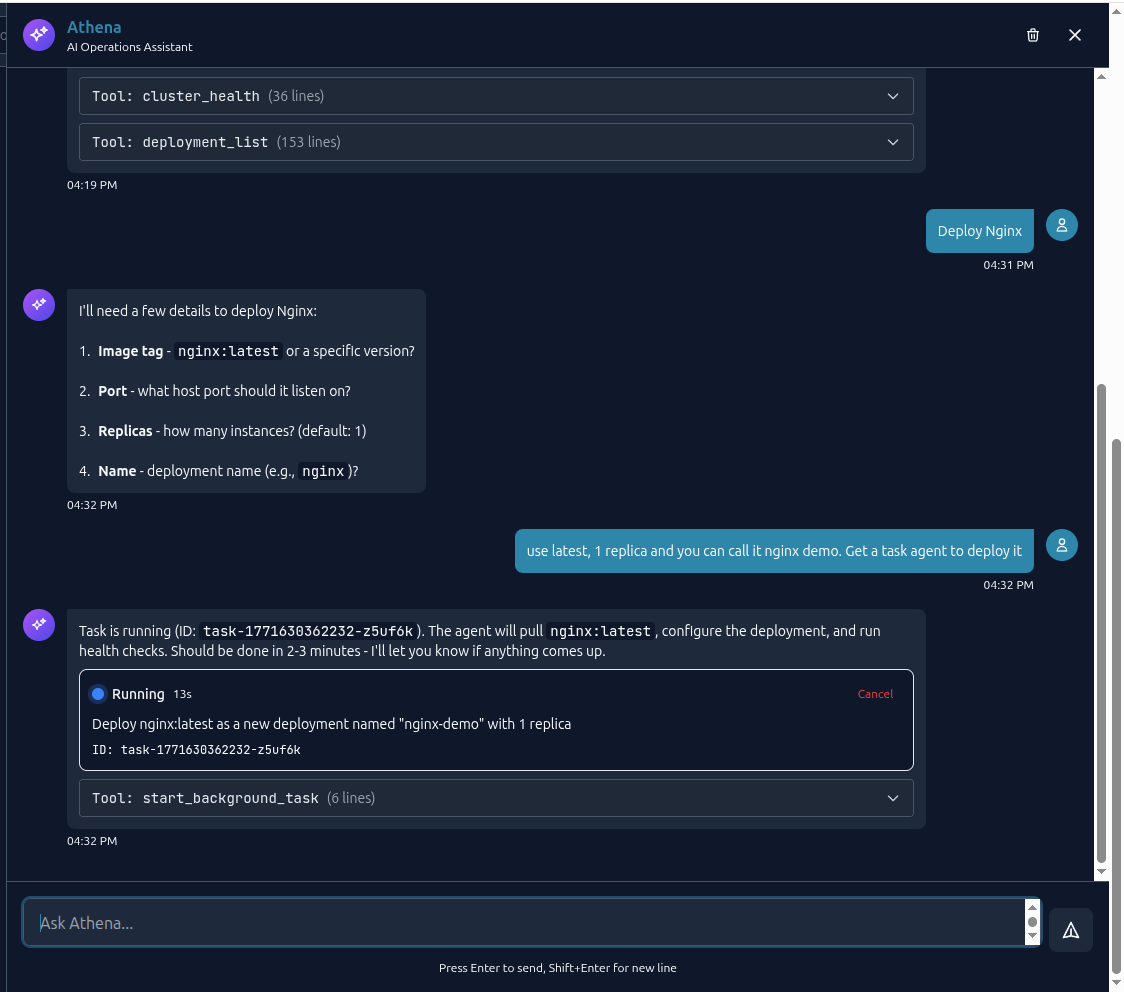
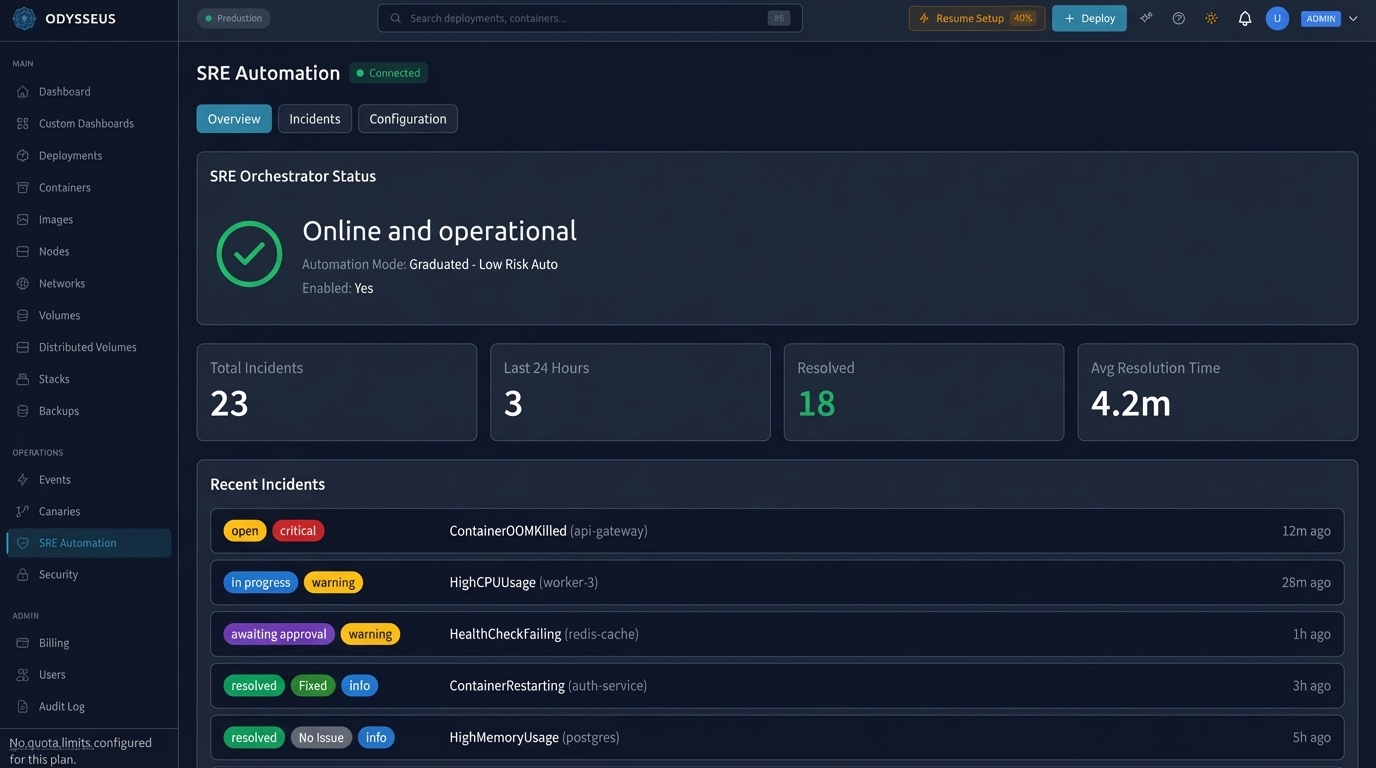
SRE 编排器 —— 自愈基础设施
实时检测容器崩溃、OOM 终止、健康检查失败和性能异常。集成的 LLM 诊断根本原因并执行安全修复——采用渐进式滚动更新和人工审批防护栏。
LLM 驱动的分析
具有可配置超时、令牌限制和自定义系统提示的多轮 AI 分析。LLM 调查、诊断并提出命令——每个命令都标记有风险级别。
可配置的防护措施
设置每个事件的最大命令数、冷却期、危险命令模式和每服务黑名单。控制哪些严重性和风险级别可以自动执行。
完整的事件生命周期
事件经历打开、进行中、等待审批、已解决、失败或已升级状态——具有去重、关联和解决跟踪(已修复、已忽略、外部、无需操作)。
在每节点 50–100 个容器时——以及更多情况下——使用的正确工具
Odysseus 专为 Docker Compose 失效而 Kubernetes 又过于复杂的场景而设计——并从此处继续发展。Nomad 是此表中最接近的同类产品;当它与我们匹配或超越我们时,该行会说明。
| 能力 | Docker Compose | Odysseus | Kubernetes | Nomad[5] |
|---|---|---|---|---|
| 自动扩缩容 | Prometheus 驱动 | 复杂配置 | 独立的自动扩缩容代理程序 | |
| 零停机部署 | 滚动更新 update 阻止 |
|||
| 金丝雀部署 | 自动提升 + 回滚 | 通过Istio/Argo | 自动提升 + 自动回滚 | |
| 即时回滚 | 回滚到上一个稳定版本 | |||
| RBAC | 4个内置角色 | 复杂的RBAC | ACL 策略和角色 | |
| 审计跟踪 | 内置 — 哈希链式、可独立验证 | 通过附加组件 | 仅限企业版 | |
| Vault 密钥注入 | 创建时从 Vault 读取,永不存储 | 通过 sidecar | 原生的 tmpfs 密钥目录 | |
| 地理数据驻留 | 按 ISO 国家或地区进行放置过滤[1] | 通过自定义标签上的节点亲和性 | 区域和数据中心约束 | |
| 租户隔离 | 节点被注册到租户 | 命名空间;节点是集群范围的 | 命名空间;节点是共享的 | |
| 多网络容器 | 有限的 | 原生 | 通过CNI插件 | 每个任务一个 network_mode |
| 控制平面 RAM | 无 — 仅限 CLI | 47–65 MB 已测量 | 每台机器最低 2 GB [2] | 每台服务器 8–16 GB,三台或五台服务器 |
| 每节点代理程序 RAM | 无 — 仅限 CLI | ~28 MB 测量值 | 在 K3s 上测量为 275 MB;托管提供商预留 574 MB – 1.9 GB[3] | 无公开数据 |
| 学习曲线 | 小时 | 天 | 月 | 天 |
| AI 运维助手 | Athena (84 个工具)[6] | |||
| CVE 扫描 | Trivy + Grype | 通过附加组件 | 通过附加组件 | |
| 自动事件响应 | AI 驱动的 SRE | 通过附加组件 | 重启与重新调度策略 | |
| 专属平台团队 | 0 | 0 | 1–2 名工程师 | 您自行运行服务器 |
| 每个节点的容器数 | 1–20 个容器 | 50–100+ 个容器[4] — 平台总容量随节点数量扩展 | 每个节点[4] 110 个 Pod — 一个 Pod 包含一个或多个容器 | 无公开上限 — 在他们自己的两百万容器运行中,每个客户端约 330 个 |
这些数字和声明是如何得出的
-
地理数据驻留是一种放置过滤器,默认处于关闭状态。
一个部署携带
odysseus.io/data-residency-country— 一个 ISO 3166-1 alpha-2 代码,例如CA或DE— 或odysseus.io/data-residency-region,它指代一个由操作员定义的 这些代码的集合,或odysseus.io/blocked-countries。调度器在放置任何内容之前,会将每个代码与节点自身的国家和地区标签 进行比较, 不满足要求的节点将从候选集中移除 — 因此 部署无法落在其允许的地理范围之外,而不是事后才被发现。 它通过控制平面配置按安装实例启用,默认关闭;区域是操作员自己的定义,不是我们的。 Kubernetes 可以表达相同的约束:它提供topology.kubernetes.io/region和topology.kubernetes.io/zone作为 知名的节点标签,以及节点亲和性来基于它们进行选择,但它没有自己的国家或驻留标签 — 因此那里的驻留是通过自定义标签和亲和性规则组装的 — kubernetes.io。 区别在于概念所处的位置,而非是否能够实现。 Nomad 不需要这样的组装,这一行并非与之区分的差异点: region 和 datacenter 在其架构中是一等公民,一个作业 可以基于${node.datacenter}、${node.region}或 任何操作员设定的${meta.<key>}值来约束放置。那里不同的 是词汇而非能力 — 我们的是一个承载 ISO 国家代码和 区域成员关系的命名驻留标签,他们的是一个指向操作员写在节点上的任何内容的通用约束。 -
Odysseus 的内存数据是实测值,而非模型估算。两者均为运行进程的常驻内存(RSS),采样窗口为 2026 年 8 月 20 日的 14 分钟,覆盖两个在线安装实例:生产环境(控制平面 47–51 MB,基于 19 个采样点;节点代理程序 26–28 MB)和开发环境(控制平面 49–64 MB,基于 18 个采样点;节点代理程序 26–28 MB)。每个安装实例运行一个控制平面;每个节点运行一个代理程序。控制平面通过其 Prometheus
/metrics端点将该数据自身发布为process_resident_memory_bytes,因此可直接核查,无需依赖信任。我们引用 RSS 而非docker stats,因为后者包含可回收的页面缓存,在新启动的容器中,其读数可能高出数倍,但这些内存并不属于编排器。Kubernetes 的数据来自上游 kubeadm 安装指南中记录的最低要求:“每台机器 2 GB 或更多 RAM”—— kubernetes.io。 -
每节点对比。上游 Kubernetes 未为其节点代理程序发布默认预留值——
kubeReserved和systemReserved均未提供——因此没有单一的官方数字可供引用。此处使用的性能分析数据来自 SUSE 发布的 K3s 资源分析,该分析将代理程序(工作)节点上的 Kubernetes 组件——其原文为“kubelet 和 k3s 代理程序”——在 Intel 8375C 上的内存占用定为 275 MB,基于稳态下的第 95 百分位读数—— docs.k3s.io。K3s 是一个集成了自有运行时的单一合并二进制文件,因此该数值是上游 Kubernetes 以独立进程运行相同组件时的下限,并非等效值。预留值是托管服务提供商在调度任何应用容器之前,从每个工作节点中扣除的容量,根据其自身发布的公式计算得出:AWS EKS 预留(11 × max-pods) + 255MiB(在 m5.large 上为 574 MiB,该实例支持 29 个 Pod)—— docs.aws.amazon.com;Google GKE 预留前 4 GiB 的 25% 和接下来 4 GiB 的 20%,外加 100 MiB(在 8 GiB 节点上约为 1.9 GiB)—— cloud.google.com。预留容量是调度器扣除的额度,并非实测消耗;我们如此标注是因为两者并非同一概念。 - 容器数量按节点计算,我们的表述是关于适用性的说明,而非上限。该范围描述了 Odysseus 设计定位的区间——高于 Docker Compose 力所不及之处,低于 Kubernetes 复杂性开始显现之点。这是定位说明,而非基准测试结果,我们亦不将其呈现为基准。平台总数是该每节点数据乘以控制平面管理的节点数量——这是架构的必然结果,而非我们在集群规模下实测的数据,因此我们也不发布集群规模的数字。Kubernetes 的数据来自该项目自身记录的受支持集群上限:“每节点不超过 110 个 Pod”,同时声明“不超过 5,000 个节点”和“不超过 300,000 个总容器”—— kubernetes.io。两列统计的单位不同——Kubernetes 限制的是 Pod,一个 Pod 包含一个或多个容器,而我们统计的是容器——因此应将它们视为相邻数据,而非可互换数据。我们不进行两者间的换算,因为比例取决于 Pod 的构建方式。托管发行版的上限更低:AWS EKS 根据机器的网络接口而非该文档记录的数字来推导每节点 Pod 上限,其自身示例为双 vCPU 机器上的 29 个 Pod——即注释 3 中引用的文档。Nomad 完全未发布每节点上限,因此其单元格如此说明,而非提供数字。HashiCorp发布的最大运行规模是其自身的演示:在 10 个 AWS 区域中,6,100 个客户端(Nomad 对运行其代理程序的节点的称呼)上运行 2,000,000 个容器,由三个服务器在 22 分钟内完成调度—— hashicorp.com ——平均每个客户端约 330 个容器。这是演示而非受支持的上限,且该数字大于我们运行过的任何规模。
-
Nomad 列的数据有来源,且在多个行中胜出。Nomad 是本表中与 Odysseus 最接近的同类——单一二进制文件、资源占用轻、并设计为与本平台运行的同一 Consul 集成——因此,适用于 Kubernetes 的对比框架在此处并不公平,我们未采用。滚动更新、带有
auto_promote的金丝雀发布、失败部署的自动回滚以及回退到上一个稳定作业,均在社区版作业规范的update块中—— developer.hashicorp.com。自动扩缩容功能是真实的,并作为第二个守护进程运行:Nomad Autoscaler “独立于 Nomad 构建和发布”,覆盖水平应用和集群扩缩容,并在其指标源中读取 Prometheus—— developer.hashicorp.com。密钥处理至少与我们相当:任务的secrets/目录由内存文件系统支持,并以noexec方式挂载—— developer.hashicorp.com。ACL 策略和角色属于社区版。非社区版功能包括:审计日志、资源配额和 Sentinel 策略属于 Nomad 企业版,将单个作业跨联合区域部署也是如此——但联合区域本身不是—— developer.hashicorp.com。命名空间属于社区版,用于分隔作业、分配、部署和评估;文档明确说明“Nomad 不对跨多个命名空间共享的对象进行命名空间划分。这包括节点”—— developer.hashicorp.com。Kubernetes 划定了相同的界限——“低层级资源,如节点……不属于任何命名空间”—— kubernetes.io;在本平台上,节点被注册到一个租户,这正是该行所记录的内容。服务器数据来自 HashiCorp 自身的参考架构——“一个 Nomad 集群通常由三到五台服务器组成”,对于小型生产部署,每台服务器配置 2 到 4 个核心和 8 到 16 GB 内存—— developer.hashicorp.com。这是读者应像我们对待注释 2 中 Kubernetes 数据那样看待的机器规格建议:是推荐值,而非实测的进程内存。我们未找到客户端代理程序的公开数据,因此该列说明无此数据,而非猜测;关于学习曲线的行是我们的估计,而非任何人的实测值。 -
Athena 工具计数是调用点的计数,而非整数。
它在
server.registerTool(中有athena-mcp/src/tools/*.ts个调用点 ——截至撰写时为 80 个——并应用了两项修正:cronjob_suspend/cronjob_resume对是从循环内的单个调用点注册的(一个点,两个工具,因此 +1),而三个发现 辅助程序(search_tools、describe_tool、request_tool) 是由makeDiscoveryTools()在server.ts中单独注册的 而非通过匹配该模式的调用注册(+3)。80 − 1 + 2 + 3 = 84。任何人都可以 通过针对标记的 版本运行grep -rc "server.registerTool(" athena-mcp/src/tools/*.ts来复现基础数字,并根据上述两项修正重新推导出相同的总数。
简单、透明的定价
基础费用 + 按节点定价,随您扩展。免费开始,随发展升级。
适用于独立开发者、家庭实验室和评估使用。
- 最多 3 个节点
- 1 个用户
- 完全兼容 Docker Compose
- WireGuard VPN 网格
- 基本 Prometheus 指标
- 2层 RBAC
- 社区支持
- 无 Athena AI
- 无 CVE 扫描
适用于运行小型生产工作负载的个人开发者和微型团队。
- 最多 5 个节点
- 最多 3 个用户
- Athena AI(每月 100 次查询)
- 每周 CVE 扫描
- 金丝雀部署
- Vault 密钥注入
- 基础 SRE 自动化
- 30天审计跟踪
- 邮件支持(48小时SLA)
适用于中小型企业的生产工作负载。核心商业层级。
- 最多 50 个节点
- 无限用户
- 无限 Athena AI
- 持续 CVE 扫描 + 策略门控
- 完整的金丝雀自动提升/回滚
- Prometheus 自动扩缩容
- 全面 SRE 自动化(8 种事件类型)
- 全面 4 层 RBAC
- 90 天审计跟踪
- 优先支持(4小时SLA)
托管服务提供商、MSP 和代理商在一个控制平面上运行多个客户,以多租户作为实际边界。相关定价需要沟通,而非固定价格。
Delta Telematics 是一家加拿大公司,本网站以英语、法语和简体中文发布。您的节点归您所有:工作负载、卷以及其中的数据位于您控制的服务器上,在您自己的管辖区域内,而控制平面仅保存编排状态,而非您应用程序的数据。个人信息根据 PIPEDA 进行处理。地理位置强制执行——将工作负载固定到您自己集群中的某个国家或地区——功能可用,但默认关闭。
开始编排
10 分钟内即可完成。
注册、连接您的第一个节点并完成部署——全程不到 10 分钟。无需 Kubernetes 专业知识,无需专门的平台团队。